Kapitel 5
Automaten und formale Sprachen
Skript Informatik · Grundkurs
Notebooks in diesem Kapitel NB05
Alle Notebooks der Klasse · Das grüne Schild an einer Überschrift zeigt, zu welchem Notebook der Abschnitt gehört.
PDF zum Ausdrucken zusammenstellen
Kreuze an, welche Abschnitte du brauchst. Die PDF hat dasselbe Aussehen wie das gedruckte Skript, mit Platz zum Schreiben. Jeden Abschnitt gibt es auch einzeln unter seiner Überschrift, das ganze Kapitel unten auf der Seite.
Sie geben im Onlineshop Ihre E-Mail-Adresse ein und vergessen das @.
Noch bevor Sie auf „Bestellen“ klicken, färbt sich das Feld rot. Ob es
die Adresse gibt, weiß die Seite nicht — aber dass
max.mustermann.de keine sein kann, sieht sie
sofort. So etwas passiert ständig um Sie herum: Das Drehkreuz im Freibad
lässt Sie erst nach dem Chip durch, die Ampel weiß, dass nach Rot-Gelb
Grün kommt, und Ihr Handy entsperrt sich erst nach der richtigen
Ziffernfolge. Hinter all dem steckt dieselbe einfache Maschine. Um sie
geht es in diesem Kapitel.
Auch ein Compiler liest Ihr Programm und weiß nach dem Bruchteil einer Sekunde, ob es regelgerecht aufgebaut ist. Er versteht dabei nicht, was Sie vorhaben — er prüft nur, ob die Zeichenfolge den Regeln der Sprache gehorcht. Genau diese Trennung macht ihn möglich: Form lässt sich mechanisch prüfen, Bedeutung nicht.
Dieses Kapitel baut das Werkzeug dafür auf. Erst die Frage, was eine Sprache formal überhaupt ist, dann Grammatiken als Regelwerk zum Erzeugen von Wörtern, dann endliche Automaten als Maschinen zum Erkennen von Wörtern. Am Ende steht ein Programm, das eine solche Maschine ausführt — und die Einsicht, wo diese einfachen Maschinen an ihre Grenze stoßen.
Am Ende dieses Kapitels können Sie
- natürliche und künstliche Sprachen unterscheiden und Syntax von Semantik trennen,
- die Arbeitsweise von Interpreter und Compiler beschreiben,
- die Begriffe Alphabet, Wort, und formale Sprache sicher verwenden,
- eine Grammatik aus Terminalen, Nichtterminalen, Produktionen und Startsymbol angeben und Ableitungen samt Ableitungsbaum aufschreiben,
- reguläre Grammatiken erkennen und zu einer Sprache einen endlichen Automaten konstruieren — als Zustandsgraph und als Übergangstabelle,
- deterministische von nichtdeterministischen Automaten unterscheiden und einen NEA mit der Teilmengenkonstruktion in einen DEA umwandeln,
- eine reguläre Grammatik in einen endlichen Automaten und einen Automaten zurück in eine Grammatik übersetzen,
- einen endlichen Automaten programmieren,
- reguläre Ausdrücke lesen, schreiben und ihren Zusammenhang zu Automaten und Grammatiken erklären,
- Mealy- und Moore-Automaten unterscheiden und Übergangs- samt Ausgabetabelle angeben,
- begründen, warum endliche Automaten Klammerstrukturen nicht prüfen können,
- die vier Stufen der Chomsky-Hierarchie verbal charakterisieren und je ein Beispiel für eine nicht-reguläre und eine nicht-kontextfreie Sprache nennen.
5.1Sprachen und ihre Regeln
Diesen Abschnitt als PDF (S. 2)
Tippen Sie in Ihren Taschenrechner 3 + × 4. Viele
Modelle antworten mit Syntax ERROR: Die Zeichenfolge ist gar
keine Rechnung, der Rechner kann sie nicht einmal lesen. Tippen Sie
dagegen 5 ÷ 0, kommt Math ERROR: Die Eingabe ist
tadellos gebaut, nur ergibt sie keinen Sinn. Ihr Taschenrechner
unterscheidet damit genau die zwei Ebenen, um die es in diesem Abschnitt
geht.
Sprachen dienen der Verständigung. Man unterscheidet natürliche Sprachen, die zwischen Menschen gewachsen sind (Deutsch, Französisch), und künstliche Sprachen, die jemand bewusst festgelegt hat. Programmiersprachen gehören dazu, aber auch die Formelsprache der Mathematik.
Jede Sprache gehorcht Regeln auf zwei Ebenen:
- Die Syntax legt die erlaubte Form von Wörtern und Sätzen fest.
- Die Semantik bestimmt deren Bedeutung.
Der Unterschied lässt sich am Beispiel zeigen. Der Satz „Der Hund ist
ein Insekt” ist syntaktisch einwandfrei und semantisch falsch. Die Zeile
x := "drei" + 5; ist umgekehrt semantisch klar gemeint und
syntaktisch bzw. typmäßig unzulässig. Ein Compiler prüft die Syntax
vollständig, die Semantik nur zu einem kleinen Teil — deshalb erzeugt
ein fehlerfrei übersetztes Programm noch lange nicht das gewünschte
Ergebnis.
Dass natürliche Sprachen erheblich komplizierter sind als Programmiersprachen, zeigt schon ein einziger Satz:
Die deutsche Umgangssprache ist, wie jeder, der sie — und das wird an diesem Satz hier, den ich der Erläuterung wegen einschiebe, deutlich — lernen muss, weiß, eine sehr komplizierte Sprache.
Ein Mensch versteht ihn nach zweimaligem Lesen. Eine Maschine bräuchte dafür eine Grammatik, die beliebig tief verschachtelte Einschübe erlaubt — genau die Art von Struktur, an der die Automaten dieses Kapitels scheitern werden (Abschnitt 5.10).
- Nennen Sie je zwei natürliche und zwei künstliche Sprachen und begründen Sie die Zuordnung.
- Geben Sie ein Beispiel für einen deutschen Satz, der syntaktisch korrekt, aber semantisch sinnlos ist — und eines für den umgekehrten Fall.
- Ihr Programm übersetzt fehlerfrei, liefert aber falsche Ergebnisse. Welche Ebene ist betroffen? Begründen Sie.
Lösung vergleichen
- Natürlich: Deutsch, Französisch — gewachsen im Gebrauch zwischen Menschen, ohne dass jemand die Regeln vorab festgelegt hat. Künstlich: Python, die Formelsprache der Mathematik — bewusst festgelegt, mit genau definierter Syntax.
- Syntaktisch korrekt, semantisch sinnlos: „Der Kühlschrank liest grüne Gedanken.“ Umgekehrt, gemeint ist etwas Klares, die Form ist falsch: „Ich morgen Kino gehen.“
- Die Semantik. Der Compiler hat die Syntax vollständig geprüft — sonst hätte er nicht übersetzt. Falsche Ergebnisse entstehen, weil das Programm etwas anderes bedeutet, als beabsichtigt war, etwa durch eine falsche Formel oder Bedingung.
5.2Vom Quelltext zur Maschine
Diesen Abschnitt als PDF (S. 3)
Bei einer Pressekonferenz überträgt eine Dolmetscherin jeden Satz, während der Gast noch spricht — wiederholt er sich, übersetzt sie eben noch einmal. Ein Roman dagegen wird einmal vollständig übersetzt, gedruckt und dann tausendfach gelesen, ohne dass der Übersetzer noch dabei ist. Genau diese beiden Wege gibt es auch, um ein Programm auf den Prozessor zu bringen.
Ein Prozessor versteht nur seine eigene Maschinensprache. Der Weg dorthin führt über eines von zwei Verfahren.
Ein Interpreter bekommt Programm und Eingabedaten gleichzeitig und führt jede Anweisung sofort aus. Jede Zeile ist ihm auch beim hundertsten Schleifendurchlauf wieder neu — das kostet Zeit, erlaubt aber sofortiges Ausprobieren. Python arbeitet im Kern so.
Ein Compiler (von to compile, zusammenstellen) trennt beides zeitlich: Zuerst wird das Programm unabhängig von allen Eingabedaten analysiert und in die Zielsprache übersetzt, danach läuft das Ergebnis beliebig oft. Delphi und C++ arbeiten so.
Quellsprache          →   Compiler   →   Zielsprache
(Pascal, Delphi, C)                      (Maschinen-, Assemblersprache)
Die Übersetzung zerfällt in zwei Phasen:
- Analyse. Die lexikalische Analyse zerlegt den Zeichenstrom in Token — Schlüsselwörter, Bezeichner, Zahlen, Operatoren. Die syntaktische Analyse prüft, ob diese Token nach den Regeln der Grammatik zusammenpassen, und baut daraus einen Ableitungsbaum. Fehlermeldungen entstehen hier.
- Synthese. Aus dem Baum wird der Code der Zielsprache erzeugt.
Der Lexer benutzt endliche Automaten (Abschnitt 5.6), der Parser eine Grammatik (Abschnitt 5.4). Dieses Kapitel baut also genau die beiden Werkzeuge, mit denen jeder Compiler beginnt.
- Nennen Sie je einen Vorteil und einen Nachteil von Interpreter und Compiler.
- Zerlegen Sie die Zeile
zaehler := zaehler + 1;von Hand in Token und benennen Sie deren Art. - Warum meldet der Compiler einen Tippfehler in einem Schlüsselwort, nicht aber eine verwechselte Variable?
Lösung vergleichen
Interpreter — Vorteil: Änderungen lassen sich sofort ausprobieren, ohne Übersetzungslauf. Nachteil: langsamer, weil jede Anweisung bei jeder Ausführung neu analysiert wird. Compiler — Vorteil: Das übersetzte Programm läuft schnell und beliebig oft. Nachteil: Nach jeder Änderung muss neu übersetzt werden.
Sechs Token:
Token Art zaehlerBezeichner :=Zuweisungsoperator zaehlerBezeichner +arithmetischer Operator 1Zahl (Literal) ;Trennzeichen Ein vertipptes Schlüsselwort (
whliestattwhile) ist für den Lexer nur ein Bezeichner — an dieser Stelle verlangt die Grammatik aber ein Schlüsselwort, die syntaktische Analyse schlägt fehl. Eine verwechselte Variable ist dagegen ein gültiger Bezeichner an einer Stelle, an der ein Bezeichner stehen darf: Die Syntax stimmt, nur die Bedeutung nicht.
5.3Alphabet, Wort und Sprache
Diesen Abschnitt als PDF (S. 4)
Ihre Handy-PIN besteht aus vier Ziffern, und 0000 zählt genauso wie 4711. Erlaubt sind die zehn Zeichen 0 bis 9, jede PIN ist eine Folge aus genau vier davon. In der Sprache dieses Abschnitts: Das Ziffernfeld ist das Alphabet, jede PIN ein Wort der Länge 4, und die PINs, die Ihr Handy entsperren, bilden eine sehr kleine Sprache. Wie viele PINs es gibt, rechnen Sie mit dem Satz weiter unten in einer Zeile aus.
Definition (Alphabet). Ein Alphabet ist eine endliche, geordnete Menge von Zeichen.
Beispiele: für Dualzahlen, für Bezeichner, für Pascal die Menge aller erlaubten Zeichen samt Schlüsselwörtern.
Definition (Wort). Ein Wort über ist eine endliche Folge von Zeichen aus . Das leere Wort wird mit bezeichnet und hat die Länge 0.
Für sind , , , und Wörter.
Bezeichnung. Die Menge aller endlich langen Wörter über heißt , die Menge aller Wörter der Länge heißt .
Satz. Ist ein Alphabet mit Zeichen, so hat genau Elemente. hat unendlich viele Elemente — aber abzählbar unendlich viele, denn man kann die Wörter der Länge nach und innerhalb gleicher Länge alphabetisch aufzählen.
Definition (formale Sprache). Jede Teilmenge heißt formale Sprache über .
Diese Definition ist großzügig: Jede beliebige Auswahl von Wörtern ist eine Sprache. Interessant werden nur die Sprachen, die sich endlich beschreiben lassen — durch eine Regel, eine Grammatik oder einen Automaten.
- . Geben Sie und vollständig an. Wie viele Elemente hat ?
- . Notieren Sie und die ersten zehn Wörter von .
- . Welche der folgenden Mengen sind formale Sprachen über ? , , , . Begründen Sie.
- Beschreiben Sie in Worten: und .
- . Geben Sie die Sprache aller Wörter der Länge 3 an, deren mittleres Zeichen ein ist. Wie viele Wörter sind das?
Lösung vergleichen
- , . hat Elemente.
- . Die ersten zehn Wörter von in alphabetischer Reihenfolge: (von insgesamt ).
- ist eine formale Sprache — die leere Menge ist Teilmenge jeder Menge. ebenfalls, denn . nicht: ist kein Zeichen aus , also kein Wort über . ist eine formale Sprache. Beachten Sie: und sind verschieden — die eine enthält kein Wort, die andere genau eines, das leere.
- : beliebig viele (auch keines), danach genau ein . : genau ein , danach beliebig viele (auch keines).
- — das sind Wörter.
5.4Grammatiken
Diesen Abschnitt als PDF (S. 5–6)
Wählen Sie aus jeder Spalte ein Teil: Mein Hund | Mein kleiner Bruder | Der Drucker — hat — meine Hausaufgaben | mein Referat — gefressen | gelöscht | versteckt. Das ergibt Ausreden, ohne dass Sie eine einzige auswendig lernen. So arbeitet eine Grammatik: wenige Regeln, viele Sätze. Ob die Ausrede glaubwürdig ist, entscheidet sie nicht — das ist Semantik.
Nicht jede Folge von Wörtern ergibt einen Satz:
- Hund alle sind.
- Der Hund ist ein Insekt.
while do end x < 3 begin
Die erste und die dritte Zeile verstoßen gegen die Form, die zweite nur gegen den Inhalt. Für die Form zuständig ist die Grammatik. Sie hat zwei Aufgaben: die zulässigen Zeichenfolgen zu beschreiben und die Regeln dafür darzustellen. Die Semantik spielt dabei keine Rolle.
Eine Grammatik ist ein 4-Tupel mit
- der Menge der Nichtterminalzeichen (syntaktische Variablen),
- der Menge der Terminalzeichen (auch Token — die Zeichen, die im fertigen Wort stehen dürfen), wobei ,
- der Menge der Produktionen (Regeln der Form „links rechts”) und
- dem Startsymbol .
Die Angabe als Tupel ist die übliche Schreibweise und wird im Abitur erwartet. Sie zwingt dazu, nichts zu vergessen: vier Klammern, vier Bestandteile.
Eine Ableitung ist eine Folge von Ersetzungen, beginnend beim Startsymbol. Die Menge aller ableitbaren Wörter über heißt die von erzeugte Sprache .
5.4.1Ein erstes Beispiel
Der Pfeil bedeutet: Das Nichtterminal links darf durch die rechte Seite ersetzt werden, der Strich trennt Alternativen. Ableitung von „Hunde schnurren”:
Der Satz gehört also zu — dass Hunde nicht schnurren, ist eine Frage der Semantik und geht die Grammatik nichts an. Grafisch notiert man die Ableitung als Ableitungsbaum:
            S
           / \
     Subjekt  Prädikat
        |        |
Hunde schnurren5.4.2Zweites Beispiel: Klammerterme
Gesucht ist eine Grammatik für korrekt geschachtelte Klammern wie
(()) oder ((()())()).
Ableitung von (())():
Beachten Sie die Regel : Das Nichtterminal steht zwischen Terminalzeichen. Diese Bauart wird in Abschnitt 5.10 entscheidend.
5.4.3Drittes Beispiel: ein Satzmuster
- Leiten Sie mit der letzten Grammatik die Sätze „der Briefträger beißt den Hund” und „der Briefträger schlägt den Briefträger” ab und zeichnen Sie je einen Ableitungsbaum.
- Wie viele verschiedene Sätze erzeugt diese Grammatik insgesamt? Begründen Sie mit einer Rechnung.
- Leiten Sie
((()))und()()()mit der Klammergrammatik ab. - Geben Sie eine Grammatik an, die alle Wörter aus und erzeugt, die mit beginnen.
- Erweitern Sie die Satzgrammatik um ein Adjektiv vor dem Nomen.
Lösung vergleichen
Erster Satz:
                 S
       /         |         \
  Subjekt    Prädikat    Objekt
   /   \         |        /   \
 der  Nomen    beißt    den  Nomen
        |                      |
   Briefträger               Hund
Zweiter Satz:
Der Baum hat dieselbe Gestalt wie oben; an den Blättern stehen „schlägt“ und unter dem Objekt wieder „Briefträger“.
Sätze: Das Nomen im Subjekt hat 2 Möglichkeiten, das Prädikat 2 und das Nomen im Objekt wieder 2. Alle anderen Regeln haben nur eine Alternative.
Zum Beispiel , , , Startsymbol . Das erste Zeichen ist immer , danach beliebig viele und .
Im Deutschen hängt die Endung des Adjektivs vom Fall ab („der große Hund“, aber „den großen Hund“). Deshalb zwei Nichtterminale: , , , . Wer nur ein Nichtterminal Adjektiv einführt, erzeugt auch „den große Hund“ — das ist syntaktisch falsch.
5.5Reguläre Grammatiken
Diesen Abschnitt als PDF (S. 7)
Wer ein Kennzeichen wie WND-AB 123 vorliest, geht Zeichen für Zeichen von links nach rechts. Merken muss er sich dabei nur eines: ob er gerade im Kreiskürzel, bei den Buchstaben oder bei den Ziffern ist. Er blättert nie zurück und muss nichts Späteres vorwegnehmen. Grammatiken, die so gebaut sind — ein Zeichen anhängen, dann weiter —, heißen regulär.
Definition. Eine Grammatik heißt regulär, wenn jede Produktion die Form
hat, mit und . Rechts steht also genau ein Terminalzeichen und dahinter höchstens ein Nichtterminal — und wenn, dann ganz rechts. Die erzeugte Sprache heißt reguläre Sprache.
Die Definition ist enger, als sie beim Querlesen wirkt. Nicht erlaubt sind (zwei Terminalzeichen), (Nichtterminal links) und (leeres Wort). Umgekehrt gilt: Eine Grammatik, die diese Form nicht hat, kann durchaus eine reguläre Sprache erzeugen — man kann sie dann in die reguläre Form umschreiben. „Regulär” ist also eine Eigenschaft der Grammatik; „reguläre Sprache” eine Eigenschaft der Sprache. Beides auseinanderzuhalten lohnt sich.
Die Klammergrammatik aus 5.4 ist nach dieser Definition nicht regulär — bei steht das Nichtterminal in der Mitte. Das ist kein Zufall, wie sich zeigen wird.
Beispiel: gerade Dualzahlen. Gesucht ist eine Grammatik für alle Dualzahlen ohne führende Null, die gerade sind — die also mit 1 beginnen und auf 0 enden.
Ableitung von 1010:
titel: Grammatik für gerade Dualzahlen
produktionen:
  S -> 1A
  A -> 0A | 1A | 0
start: S
wort: 1010
beispiele: 10, 1010, 1100, 110, 101
Geben Sie im Bedienfeld auch 101 ein — eine ungerade Zahl. Es gibt keine Ableitung, und das Werkzeug sagt es.
Beispiel: Bezeichner. In vielen Sprachen gilt: Ein Bezeichner beginnt mit einem Buchstaben, danach folgen beliebig viele Buchstaben oder Ziffern. Mit (Buchstabe, Ziffer):
- Prüfen Sie, ob die Grammatik die obige Definition erfüllt — prüfen Sie jede Produktion einzeln. Beschreiben Sie anschließend in Worten und geben Sie eine Grammatik an, die dieselbe Sprache erzeugt und die Definition erfüllt.
- Geben Sie eine reguläre Grammatik für alle ungeraden Dualzahlen an und leiten Sie und ab.
- Gibt es eine reguläre Grammatik für ? Beschreiben Sie die Sprache zuerst in Worten.
- Begründen Sie, warum nicht regulär ist.
Lösung vergleichen
- und erfüllen die Definition. nicht: zwei Terminalzeichen. und erfüllen sie, nicht: leeres Wort. ist die Menge aller Wörter über , die enthalten. Eine reguläre Grammatik dafür: . heißt „das erste des Paares ist gelesen“, „ ist schon da“.
- (die Regel erzeugt die 1). und .
- Es sind alle Dualzahlen ohne führende Null, die gerade und mindestens 2 sind — sie beginnen mit 1 und enden auf 0. Ja, das ist genau die Grammatik aus dem Beispiel: .
- Rechts stehen zwei Terminalzeichen, und das Nichtterminal steht zwischen ihnen statt ganz rechts. Beides verbietet die Definition.
5.6Endliche Automaten
Diesen Abschnitt als PDF (S. 8–12)
Das Drehkreuz kennt genau zwei Zustände: gesperrt und
frei. Halten Sie im Zustand gesperrt Ihre Karte an den Leser,
wechselt es nach frei; gehen Sie hindurch, ist es wieder gesperrt.
Drücken Sie gegen ein gesperrtes Drehkreuz, bleibt es gesperrt. Mehr
weiß es nicht — weder, wie viele Leute heute schon durch sind, noch, wer
Sie sind. Ein Türschloss mit Tastenfeld, das aufgeht, sobald die letzten
drei Tasten 7, 3, 3 waren, ist übrigens genauso gebaut wie der Automat
für „endet auf abb“ weiter unten.
titel: Das Drehkreuz im Freibad
frage: Probieren Sie: Was passiert, wenn Sie zweimal die Karte vorhalten — und was, wenn Sie gegen das gesperrte Kreuz drücken?
bild: drehkreuz
zustaende: gesperrt, frei
start: gesperrt
eingaben: Karte, drücken
uebergaenge:
  gesperrt, Karte -> frei
  gesperrt, drücken -> gesperrt
  frei, Karte -> frei
  frei, drücken -> gesperrt
bedeutung:
  gesperrt: Die Lampe ist rot, die Arme sind blockiert.
  frei: Die Lampe ist grün, ein Stoß dreht das Kreuz eine Stellung weiter.
Eine Grammatik erzeugt Wörter. Für den Compiler brauchen wir das Gegenstück: eine Maschine, die ein vorgelegtes Wort prüft. Das leistet der endliche Automat.
Ein endlicher akzeptierender Automat (Akzeptor) ist ein 5-Tupel mit
- der endlichen Zustandsmenge ,
- dem Eingabealphabet ,
- der Übergangsfunktion ,
- dem Anfangszustand ,
- der Finalmenge der Endzustände.
Der Automat akzeptiert ein Wort, wenn er nach dem Lesen des letzten Zeichens in einem Endzustand steht.
Gezeichnet wird er als Zustandsgraph: Zustände sind Kreise, Übergänge beschriftete Pfeile, der Startzustand hat einen Pfeil von außen, Endzustände einen doppelten Rand.
Beispiel: Wörter über
,
die aa enthalten.
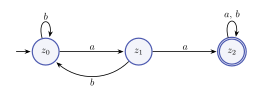
In Worten: heißt „das zuletzt gelesene Zeichen war kein “, heißt „das zuletzt gelesene Zeichen war ein , aber noch kein ”, und heißt „ ist aufgetreten” — dieser Zustand wird nie wieder verlassen. Ein in wirft zurück nach . Beachten Sie: In kann der Automat schon beliebig viele gelesen haben, nur eben nicht als letztes Zeichen. Der Zustand merkt sich nicht die Anzahl, sondern allein, wie weit das gesuchte gerade gediehen ist.
Dieselbe Information als Übergangstabelle — die Form, die man zum Programmieren braucht:
| Zustand | bei | bei | Endzustand |
|---|---|---|---|
| nein | |||
| nein | |||
| ja |
Beispiel: Wörter über
,
die auf abb enden.
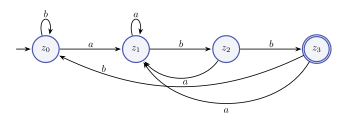
| Zustand | bei | bei | Bedeutung | Endzustand |
|---|---|---|---|---|
| nichts Passendes gesehen | nein | |||
| zuletzt | nein | |||
| zuletzt | nein | |||
| zuletzt | ja |
Der Zustand merkt sich also gerade so viel von der Vergangenheit, wie für die Entscheidung nötig ist — und keinen Buchstaben mehr. Das ist die zentrale Idee: Der Zustand ist das Gedächtnis des Automaten, und dieses Gedächtnis ist endlich.
titel: DEA: Wörter über {a, b}, die auf abb enden
zustaende: z0, z1, z2, z3
start: z0
akzeptierend: z3
uebergaenge:
  z0, a -> z1
  z0, b -> z0
  z1, a -> z1
  z1, b -> z2
  z2, a -> z1
  z2, b -> z3
  z3, a -> z1
  z3, b -> z0
beispiele: abb, aabb, abba, babb, ab, abbb
Dasselbe Muster an einer Tür: Das Tastenschloss merkt sich nur, wie viel vom Code zuletzt getippt wurde. Alle Ziffern außer 7 und 3 stehen am Pfeil als „sonst“.
titel: Das Tastenschloss mit dem Code 7-3-3
frage: Tippen Sie 7, 3, 3 — und dann einmal 7, 7, 3, 3 oder 7, 3, 7, 3, 3. Wann geht die Tür auf?
bild: tastenfeld
zustaende: z0, z1, z2, offen
start: z0
akzeptierend: offen
uebergaenge:
  z0, 3 -> z0
  z0, 7 -> z1
  z0, sonst -> z0
  z1, 3 -> z2
  z1, 7 -> z1
  z1, sonst -> z0
  z2, 3 -> offen
  z2, 7 -> z1
  z2, sonst -> z0
  offen, 3 -> z0
  offen, 7 -> z1
  offen, sonst -> z0
bedeutung:
  z0: Noch nichts Passendes getippt.
  z1: Zuletzt getippt: 7.
  z2: Zuletzt getippt: 7, 3.
  offen: Zuletzt getippt: 7, 3, 3. Die Tür ist offen.
- Zeichnen Sie den Zustandsgraphen zur zweiten Tabelle und prüfen Sie
die Wörter
abb,aabb,abba,babb. - Konstruieren Sie einen DEA für alle geraden Dualzahlen und einen für alle ungeraden.
- Konstruieren Sie einen DEA für Bezeichner nach der Regel aus 5.5.
- Konstruieren Sie einen DEA über , der genau die Wörter mit einer geraden Anzahl von akzeptiert.
- Geben Sie zu Ihrem Automaten aus Aufgabe 24 die Übergangstabelle an.
- Welche Sprache akzeptiert der Automat mit , und den Übergängen , , , ? (Tipp: Zählen Sie.)
Lösung vergleichen
Der Graph hat vier Zustände; ist Startzustand, Endzustand, die Pfeile stehen in der Tabelle. Die Läufe:
Wort Zustandsfolge Ergebnis abbakzeptiert aabbakzeptiert abbaabgelehnt babbakzeptiert Fehlende Übergänge führen jeweils in einen Fehlerzustand.
Gerade Dualzahlen (Endzustand ):
Zustand bei 0 bei 1 Endzustand – nein nein ja Ungerade Dualzahlen (Endzustand ):
Zustand bei 0 bei 1 Endzustand – nein ja nein Mit dem Alphabet :
Zustand bei bei Endzustand – nein ja Zwei Zustände: („bisher gerade viele “, Start- und Endzustand) und . Ein wechselt den Zustand, ein lässt ihn stehen. Das leere Wort wird akzeptiert — null ist gerade.
Übergangstabelle ( markiert den Startzustand):
Zustand bei bei Endzustand ja nein Eine 1 wechselt den Zustand, eine 0 nicht. Der Automat steht also genau dann in , wenn er ungerade viele Einsen gelesen hat: Er akzeptiert alle Wörter über mit einer ungeraden Anzahl von Einsen.
5.6.1Deterministisch oder nichtdeterministisch
Sie suchen in einem fremden Einkaufszentrum einen bestimmten Laden. Allein müssten Sie an jeder Gabelung raten. Mit genug Freunden geht es ohne Raten: An jeder Gabelung geht jemand in jede Richtung, und wer ankommt, ruft die anderen. Ein nichtdeterministischer Automat rechnet genau so — er verfolgt alle Wege gleichzeitig und ist zufrieden, wenn irgendeiner ankommt.
- Bei einem deterministischen Automaten (DEA) ist eindeutig: Zu jedem Paar aus Zustand und Zeichen gibt es genau einen Folgezustand.
- Bei einem nichtdeterministischen Automaten (NEA) dürfen es mehrere sein. Der Automat müsste gewissermaßen raten, welchen Weg er nimmt, und akzeptiert ein Wort, wenn irgendein Weg in einen Endzustand führt.
Beim NEA ist also keine Funktion in den Zuständen, sondern eine in die Teilmengen von : . Der Automat ist gewissermaßen in mehreren Zuständen gleichzeitig.
NEAs sind oft schneller hingeschrieben — bauen lässt sich aber nur ein DEA, denn eine Maschine kann nicht raten. Der Trost ist ein Satz:
Zu jedem NEA gibt es einen DEA, der dieselbe Sprache akzeptiert. Nichtdeterminismus bringt keine zusätzliche Mächtigkeit, nur kürzere Diagramme.
5.6.2Die Teilmengenkonstruktion
Der Beweis des Satzes ist zugleich ein Bauplan. Die Idee: Wenn der NEA in mehreren Zuständen gleichzeitig sein kann, macht man jede mögliche Zustandsmenge zu einem einzigen DEA-Zustand.
Gegeben ein NEA mit Zustandsmenge . Der zugehörige DEA entsteht so:
- Startzustand des DEA ist die Menge .
- Für jede bereits erzeugte Menge und jedes Zeichen bildet man die Menge aller Zustände, die der NEA von irgendeinem Zustand aus mit erreichen kann. Das ist der Folgezustand.
- Neu entstandene Mengen werden genauso behandelt, bis keine neue mehr auftritt.
- Endzustände des DEA sind genau die Mengen, die mindestens einen Endzustand des NEA enthalten.
Der NEA rät, wann das letzte ab beginnt:
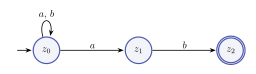
a |
b |
|
|---|---|---|
Endzustand ist
.
In
ist der Automat nichtdeterministisch: Bei a kann er dort
bleiben oder nach
wechseln.
Im Simulator sehen Sie die Zustandsmenge wandern — genau das, was die Teilmengenkonstruktion gleich zu einzelnen Zuständen zusammenfasst:
titel: NEA: Wörter über {a, b}, die auf ab enden
zustaende: z0, z1, z2
start: z0
akzeptierend: z2
uebergaenge:
  z0, a -> z0 | z1
  z0, b -> z0
  z1, b -> z2
beispiele: ab, aab, abab, aba, b
Durchführung. Start ist .
| Menge | mit a |
mit b |
|---|---|---|
Keine neue Menge mehr — fertig. enthält und ist damit der einzige Endzustand.
Der fertige DEA:
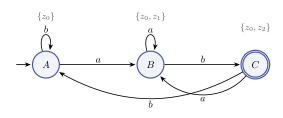
Übergangstabelle des DEA:
a |
b |
|
|---|---|---|
Probe: bab läuft
— akzeptiert. aba läuft
— abgelehnt, richtig, denn aba endet nicht auf
ab.
Hat der NEA Zustände, hat der DEA höchstens — so viele Teilmengen gibt es. Meist sind es weit weniger, weil die meisten Mengen nie erreicht werden. Im Beispiel waren es 3 statt der möglichen 8.
- Konstruieren Sie mit der Teilmengenkonstruktion einen DEA zu dem NEA über mit , , , . Welche Sprache akzeptiert er?
- Geben Sie zum DEA aus dem Beispiel das 5-Tupel vollständig an.
- Zeichnen Sie einen NEA, der alle Wörter über
akzeptiert, die
aaoderbbenthalten, und wandeln Sie ihn um. Wie viele Zustände hat der DEA?
Lösung vergleichen
Start ist :
Menge mit 0 mit 1 Endzustand ist . Der Automat akzeptiert alle Wörter über , die auf
01enden — dasselbe Muster wie im Beispiel, mit 0 statt und 1 statt .mit , , , , , .
Ein NEA mit vier Zuständen: (Start), („ein gelesen“), („ein gelesen“) und (Endzustand). , , , , . Die Teilmengenkonstruktion:
Menge mit mit Endzustand nein nein nein ja ja Der DEA hat 5 Zustände. und verhalten sich gleich — beide Endzustände, beide gehen bei nach und bei nach . Fasst man sie zusammen, bleiben 4.
5.7Automaten mit Ausgabe
Diesen Abschnitt als PDF (S. 13–16)
Der GK-Lehrplan nennt ausdrücklich „endliche Automaten ohne Ausgabe”. Mealy- und Moore-Automaten samt Ausgabetabelle stehen nur im LK-Lehrplan — dort sogar mit genau dem Beispiel, das hier durchgerechnet wird: Erzeuger und Prüfer eines Paritätsbits.
Bisher konnte unser Automat nur eines: am Ende ja oder nein sagen. Ein Getränkeautomat tut mehr — er gibt Wechselgeld heraus, schaltet eine Lampe ein, wirft eine Flasche aus. Solche Maschinen liefern während des Lesens Ausgaben.
Der Akzeptor ist dafür der Sonderfall: ein Automat, dessen einzige Ausgabe die Antwort am Schluss ist. Die allgemeine Form hat ein Ausgabealphabet dazu.
Ein endlicher Automat mit Ausgabe ist ein 6-Tupel : Zu Zustandsmenge, Eingabealphabet, Übergangsfunktion und Anfangszustand kommen ein Ausgabealphabet und eine Ausgabefunktion hinzu. Eine Finalmenge gibt es nicht — die Antwort steckt in der Ausgabe, nicht im Zustand am Ende. Zwei Bauarten unterscheiden sich darin, woran die Ausgabe hängt:
- Mealy-Automat:
— die Ausgabe hängt an Zustand und Eingabe, steht also
am Übergang. Geschrieben wird sie an den Pfeil als
Eingabe / Ausgabe. - Moore-Automat: — die Ausgabe hängt nur am Zustand. Sie steht im Kreis, die Pfeile tragen nur die Eingabe.
Beide sind gleich mächtig: Zu jedem Mealy-Automaten gibt es einen Moore-Automaten mit derselben Wirkung und umgekehrt. Der Mealy-Automat kommt dabei meist mit weniger Zuständen aus, der Moore-Automat ist leichter zu lesen.
Eine Ampel ist ein Moore-Automat: Welche Lampen leuchten, hängt allein an ihrem Zustand, und der Takt schaltet sie von Phase zu Phase. Der Getränkeautomat verhält sich wie ein Mealy-Automat: Die Flasche fällt in dem Moment, in dem die letzte Münze eingeworfen wird — die Ausgabe gehört zum Übergang, nicht zum Zustand.
titel: Die Ampel als Moore-Automat
frage: Die Ausgabe hängt nur am Zustand: Jede Phase hat ihre eigenen Lampen.
bild: ampel
zustaende: rot, rotgelb, grün, gelb
start: rot
eingaben: Takt
takt: Takt
uebergaenge:
  rot, Takt -> rotgelb
  rotgelb, Takt -> grün
  grün, Takt -> gelb
  gelb, Takt -> rot
ausgaben:
  rot: rot
  rotgelb: rot + gelb
  grün: grün
  gelb: gelb
titel: Der Getränkeautomat als Mealy-Automat
frage: Eine Flasche kostet 1,50 €. Der Zustand ist das Guthaben in Cent, die Ausgabe steht am Pfeil.
bild: getraenk
zustaende: 0, 50, 100
start: 0
eingaben: 50 ct, 1 €
uebergaenge:
  0, 50 ct -> 50
  0, 1 € -> 100
  50, 50 ct -> 100
  50, 1 € -> 0 / Flasche
  100, 50 ct -> 0 / Flasche
  100, 1 € -> 0 / Flasche + 50 ct
bedeutung:
  0: Noch kein Geld im Automaten.
  50: 50 ct Guthaben.
  100: 1 € Guthaben.
5.7.1Beispiel: ein Paritätsbit erzeugen
Beim Übertragen von Daten hängt man oft ein Paritätsbit an: ein zusätzliches Bit, das so gewählt wird, dass die Gesamtzahl der Einsen gerade ist. Kippt unterwegs ein einzelnes Bit, stimmt die Rechnung nicht mehr und der Fehler fällt auf.
Der Erzeuger braucht dafür genau zwei Zustände — mehr muss er sich nicht merken:
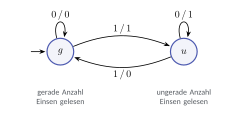
Die Ausgabe ist jeweils die Parität nach dem gelesenen Zeichen. Das zuletzt ausgegebene Bit ist damit das gesuchte Paritätsbit.
Dieselbe Information als Übergangs- und Ausgabetabelle:
| Zustand | bei 0 | Ausgabe | bei 1 | Ausgabe |
|---|---|---|---|---|
| (gerade) | 0 | 1 | ||
| (ungerade) | 1 | 0 |
| gelesen | 1 | 0 | 1 | 1 | |
|---|---|---|---|---|---|
| Zustand | |||||
| Ausgabe | 1 | 1 | 0 | 1 |
Das letzte Ausgabebit ist 1 — gesendet wird also 10111.
Die Probe: 10111 enthält vier Einsen, und vier ist
gerade.
Derselbe Automat als Moore-Maschine. Die Ausgabe wandert vom Pfeil in den Zustand:
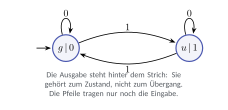
Die Tabelle wird dadurch schmaler — die Ausgabespalte gehört jetzt zum Zustand, nicht zum Übergang:
| Zustand | Ausgabe | bei 0 | bei 1 |
|---|---|---|---|
| (gerade) | 0 | ||
| (ungerade) | 1 |
Zählen Sie die Ausgaben nach: Der Mealy-Automat liefert zu
1011 die vier Bits
— eines pro gelesenem Zeichen. Der Moore-Automat liefert fünf, nämlich
:
Er gibt schon im Anfangszustand aus, bevor überhaupt ein Zeichen gelesen
ist. Das letzte Bit ist in beiden Fällen dasselbe und damit das gesuchte
Paritätsbit; bei einem Wort der Länge
hat ein Mealy-Automat aber
Ausgaben und ein Moore-Automat
.
„Gleich mächtig” heißt also nicht „Ausgabe für Ausgabe gleich”.
5.7.2Beispiel: das Paritätsbit prüfen
Auf der Empfängerseite genügt wieder ein Akzeptor — hier interessiert nur ja oder nein. Er liest Datenwort und Paritätsbit und akzeptiert, wenn die Zahl der Einsen gerade ist:
Vergleichen Sie ihn mit dem Automaten aus Aufgabe 26: Dieselben Übergänge, aber der jeweils andere Zustand ist Endzustand. Zwei Automaten, die sich nur in der Finalmenge unterscheiden, akzeptieren genau die zueinander komplementären Sprachen.
Erzeuger und Prüfer haben denselben Zustandsgraphen. Der Unterschied liegt allein darin, was man von ihm will: Der Erzeuger gibt bei jedem Schritt etwas aus, der Prüfer sagt am Ende nur, ob er in einem Endzustand steht.
Ein Paritätsbit erkennt einen gekippten Bitfehler sicher. Kippen zwei Bits, ist die Parität wieder in Ordnung und der Fehler bleibt unentdeckt. Und korrigieren kann es gar nichts — es sagt nur, dass etwas falsch ist, nicht was.
- Lassen Sie den Erzeuger auf
1101und0000laufen. Notieren Sie Zustände und Ausgaben wie in der Tabelle oben. Welches Paritätsbit wird angehängt? - Prüfen Sie mit dem Prüfer die Wörter
10111,10011und11011. Welche sind unterwegs verfälscht worden? - Zeichnen Sie einen Mealy-Automaten für einen Getränkeautomaten, der 50-Cent- und 1-Euro-Stücke annimmt und bei 1,50 € eine Flasche ausgibt. Was gibt er bei 2 € aus?
- Ein Moore-Automat gibt bei jedem gelesenen Zeichen aus, ob die bisher gelesene Zeichenzahl gerade ist. Zeichnen Sie ihn.
- Geben Sie denselben Automaten als Mealy-Automat an. Wie viele Ausgaben liefern die beiden zu einem Wort der Länge 6?
- Begründen Sie, warum der Akzeptor ein Sonderfall des Automaten mit Ausgabe ist.
Lösung vergleichen
Für
1101:gelesen 1 1 0 1 Zustand Ausgabe 1 0 0 1 Paritätsbit 1, gesendet wird
11011. Für0000:gelesen 0 0 0 0 Zustand Ausgabe 0 0 0 0 Paritätsbit 0, gesendet wird
00000.10111hat vier Einsen,11011ebenfalls — beide enden in und sind in Ordnung.10011hat drei Einsen, endet in und ist verfälscht.Die Zustände merken sich das Guthaben: , und Cent; Start ist .
Zustand bei 50 ct Ausgabe bei 1 € Ausgabe – – – Flasche Flasche Flasche + 50 ct Bei 2 € in zwei 1-€-Stücken gibt er eine Flasche und 50 ct Wechselgeld aus. Bei vier 50-ct-Stücken kommt die Flasche schon nach der dritten Münze; die vierte bleibt als Guthaben von 50 ct stehen.
Zwei Zustände, die Ausgabe steht im Kreis: / „ja“ (Start) und / „nein“. Jedes gelesene Zeichen wechselt den Zustand.
Als Mealy-Automat stehen die Ausgaben am Übergang: und für jedes Zeichen . Zu einem Wort der Länge 6 liefert der Mealy-Automat 6 Ausgaben, der Moore-Automat 7 — er gibt schon vor dem ersten Zeichen aus.
Ein Akzeptor ist ein Moore-Automat mit dem Ausgabealphabet : genau für . Von seinen Ausgaben interessiert nur die letzte. Die Finalmenge ist also nur eine besondere Ausgabefunktion.
5.8Grammatik und Automat sind zwei Seiten derselben Sache
Diesen Abschnitt als PDF (S. 17–18)
Eine Bauanleitung für ein Klemmbausteinmodell sagt, wie man es Schritt für Schritt aufbaut. Wer ein fertiges Modell vor sich hat, kann umgekehrt Stein für Stein prüfen, ob es nach dieser Anleitung gebaut ist. Beides beschreibt dasselbe Modell, einmal erzeugend, einmal prüfend. Für reguläre Sprachen sind Grammatik und Automat genau dieses Paar.
Zwischen regulären Grammatiken und endlichen Automaten lässt sich mechanisch hin- und herübersetzen.
Von der Grammatik zum Automaten. Jedes Nichtterminal wird ein Zustand, das Startsymbol der Startzustand. Aus wird der Übergang . Aus wird ein Übergang in einen zusätzlichen Endzustand .
Beispiel mit (gerade Dualzahlen). Die Regeln und beginnen beide mit einer 0 — der Zustand hat bei 0 also zwei Nachfolger:
| Zustand | bei 0 | bei 1 | Endzustand |
|---|---|---|---|
| – | nein | ||
| nein | |||
| – | – | ja |
Die Konstruktion liefert im Allgemeinen einen NEA, keinen DEA — immer dann, wenn zu einem Nichtterminal zwei Regeln mit demselben Terminalzeichen gehören. Das ist kein Mangel: Mit der Teilmengenkonstruktion aus 5.6.2 wird daraus ein DEA.
Hier von Hand nachgebaut: Aus wird ein DEA-Zustand, den wir nennen. Er ist Endzustand, weil er enthält, und verhält sich sonst wie :
| Zustand | bei 0 | bei 1 | Endzustand |
|---|---|---|---|
| – | nein | ||
| nein | |||
| ja |
Probe: läuft — akzeptiert. endet in und wird abgelehnt, richtig, denn 1011 ist ungerade.
In der Tabelle steht bei und der 0 ein Strich: Dieser Übergang kommt in der Grammatik nicht vor, weil keine Dualzahl mit 0 beginnt. Streng genommen verlangt die Definition aus 5.6 aber eine auf ganz definierte Übergangsfunktion. Man ergänzt deshalb einen zusätzlichen Fehlerzustand , der nie Endzustand ist und alle Zeichen auf sich selbst abbildet; jeder Strich führt dorthin. Gezeichnet wird er meist weggelassen, weil er das Bild unübersichtlich macht. Im Programm später entspricht ihm der Zweig „Übergang nicht in der Tabelle → abweisen”.
Vom Automaten zur Grammatik. Umgekehrt wird jeder Zustand ein Nichtterminal, der Startzustand das Startsymbol. Aus wird die Produktion — und ist ein Endzustand, so kommt zusätzlich die abschließende Regel hinzu.
Die naheliegende Abkürzung für jeden Endzustand wäre bequem, ist nach unserer Definition aus 5.5 aber nicht erlaubt: Dort darf rechts nur oder stehen, niemals das leere Wort. Deshalb der Umweg über die zusätzliche Regel.
Reguläre Grammatik, endlicher Automat und regulärer Ausdruck (Abschnitt 5.11) beschreiben genau dieselbe Klasse von Sprachen — die regulären Sprachen. Drei Schreibweisen, ein Begriff.
Ein Sonderfall bleibt: Nach unserer Definition erzeugt jede Produktion mindestens ein Zeichen, das leere Wort ist also in keiner so erzeugten Sprache enthalten. Ein Automat kann es dagegen akzeptieren — nämlich dann, wenn sein Startzustand ein Endzustand ist. Für diesen einen Fall erlaubt man zusätzlich die Regel für das Startsymbol. Mit ihr stimmen die drei Beschreibungen dann ohne Ausnahme überein.
5.9Einen Automaten programmieren
Diesen Abschnitt als PDF (S. 19–20)
Die Wache in einem Schleichspiel patrouilliert, bis sie Sie sieht. Dann verfolgt sie Sie; verliert sie Sie aus den Augen, sucht sie eine Weile und kehrt schließlich zur Patrouille zurück. Spieleentwickler programmieren solches Verhalten sehr oft als endlichen Automaten: eine Variable für den Zustand, eine Tabelle für die Übergänge. Wie wenig Code das ist, zeigt dieser Abschnitt.
titel: Die Wache im Schleichspiel
frage: Drei Zustände, drei Ereignisse. Welche Ereignisse lässt die Wache in welchem Zustand kalt?
zustaende: Runde, Jagd, Suche
start: Runde
eingaben: sieht Sie, verliert Sie, Zeit um
uebergaenge:
  Runde, sieht Sie -> Jagd
  Jagd, verliert Sie -> Suche
  Suche, sieht Sie -> Jagd
  Suche, Zeit um -> Runde
bedeutung:
  Runde: Die Wache läuft ihre Patrouille ab.
  Jagd: Die Wache verfolgt Sie.
  Suche: Die Wache sucht dort, wo sie Sie zuletzt gesehen hat.
Die Übergangstabelle lässt sich unmittelbar in Code übersetzen. Das Programm hält nur eine einzige Variable fest: den aktuellen Zustand.
Python
# Automat: akzeptiert alle Woerter ueber {a, b}, die "aa" enthalten
UEBERGAENGE = {
    ("z0", "a"): "z1", ("z0", "b"): "z0",
    ("z1", "a"): "z2", ("z1", "b"): "z0",
    ("z2", "a"): "z2", ("z2", "b"): "z2",
}
START = "z0"
ENDZUSTAENDE = {"z2"}


def akzeptiert(wort):
    zustand = START
    for zeichen in wort:
        if (zustand, zeichen) not in UEBERGAENGE:
            return False                      # Zeichen nicht im Alphabet
        zustand = UEBERGAENGE[(zustand, zeichen)]
    return zustand in ENDZUSTAENDE


for wort in ["abab", "abba", "baab", "aa", ""]:
    print(wort, akzeptiert(wort))
Object Pascal
program Automat;

type
  TZustand = (z0, z1, z2);

function Uebergang(zustand: TZustand; zeichen: Char): TZustand;
begin
  Result := zustand;
  case zustand of
    z0: if zeichen = 'a' then Result := z1 else Result := z0;
    z1: if zeichen = 'a' then Result := z2 else Result := z0;
    z2: Result := z2;                        { Endzustand bleibt erhalten }
  end;
end;

function Akzeptiert(const wort: string): Boolean;
var
  zustand: TZustand;
  i: Integer;
begin
  zustand := z0;
  for i := 1 to Length(wort) do
    zustand := Uebergang(zustand, wort[i]);
  Result := zustand = z2;
end;

begin
  WriteLn(Akzeptiert('abab'));               { False }
  WriteLn(Akzeptiert('baab'));               { True  }
end.
Beachten Sie den Unterschied im Aufbau: Python hält die Tabelle als
Datenstruktur, Pascal als case-Verzweigung. Die
Datenstruktur ist der bessere Weg — man kann einen anderen Automaten
einsetzen, ohne den Code zu ändern.
- Erweitern Sie das Python-Programm so, dass es den durchlaufenen Zustandsweg ausgibt.
- Ersetzen Sie die Tabelle durch die Ihres Automaten für „endet auf abb” und testen Sie.
- Schreiben Sie die Pascal-Fassung so um, dass sie eine
Übergangstabelle als Array
array[TZustand, 'a'..'b'] of TZustandbenutzt statt dercase-Anweisung. - Schreiben Sie ein Programm, das einen Text zeichenweise liest und prüft, ob er ein gültiger Bezeichner ist.
- Projekt: Ein Programm liest eine Übergangstabelle aus einer Textdatei und prüft dann beliebige Wörter. Damit haben Sie einen Automaten-Simulator geschrieben.
Lösung vergleichen
Der Weg wird in einer Liste gesammelt und am Ende ausgegeben:
def akzeptiert(wort):
    zustand = START
    weg = [zustand]
    for zeichen in wort:
        if (zustand, zeichen) not in UEBERGAENGE:
            print(" -> ".join(weg), "-> Fehler")
            return False
        zustand = UEBERGAENGE[(zustand, zeichen)]
        weg.append(zustand)
    print(" -> ".join(weg))
    return zustand in ENDZUSTAENDE
Für
baaberscheintz0 -> z0 -> z1 -> z2 -> z2und dannbaab True.Nur die drei Konstanten ändern sich,
akzeptiertbleibt, wie es ist:UEBERGAENGE = { ("z0", "a"): "z1", ("z0", "b"): "z0", ("z1", "a"): "z1", ("z1", "b"): "z2", ("z2", "a"): "z1", ("z2", "b"): "z3", ("z3", "a"): "z1", ("z3", "b"): "z0", } START = "z0" ENDZUSTAENDE = {"z3"}Test:
abb,aabbundbabbergebenTrue,abba,abundabbbergebenFalse.Die Tabelle wird eine Konstante, die Schleife liest nur noch nach:
const
  F: array[TZustand, 'a'..'b'] of TZustand = (
    (z1, z0),     { z0 bei a, bei b }
    (z2, z0),     { z1 }
    (z2, z2)      { z2 }
  );

function Akzeptiert(const wort: string): Boolean;
var
  zustand: TZustand;
  i: Integer;
begin
  zustand := z0;
  for i := 1 to Length(wort) do
  begin
    if not (wort[i] in ['a'..'b']) then
      Exit(False);                       { Zeichen nicht im Alphabet }
    zustand := F[zustand, wort[i]];
  end;
  Result := zustand = z2;
end;
Die Prüfung auf das Alphabet ist nötig: Ein Zeichen außerhalb von
'a'..'b'wäre sonst ein Zugriff außerhalb des Arrays.Erst wird jedes Zeichen einer Art zugeordnet, dann läuft der Automat aus Aufgabe 23:
def art(zeichen): if zeichen.isascii() and zeichen.isalpha(): return "bu" if zeichen.isdigit(): return "zi" return None UEBERGAENGE = {("S", "bu"): "R", ("R", "bu"): "R", ("R", "zi"): "R"} def ist_bezeichner(text): zustand = "S" for zeichen in text: zustand = UEBERGAENGE.get((zustand, art(zeichen))) if zustand is None: return False return zustand == "R"zaehlerundx1sind gültig,2fast,mein wertund der leere Text nicht.Ein mögliches Dateiformat: eine Zeile
start z0, eine Zeileende z3, danach je Übergang eine Zeilevon zeichen nach, also etwaz0 a z1. Das Programm liest die Datei in dasselbe Wörterbuch wie oben:def lade(dateiname): uebergaenge, start, ende = {}, None, set() with open(dateiname, encoding="utf-8") as datei: for zeile in datei: teile = zeile.split("#")[0].split() if not teile: continue if teile[0] == "start": start = teile[1] elif teile[0] == "ende": ende = set(teile[1:]) else: von, zeichen, nach = teile uebergaenge[(von, zeichen)] = nach return uebergaenge, start, endeMit der Tabelle für „endet auf abb“ in der Datei liefert der Simulator dieselben Ergebnisse wie Aufgabe 37 — ohne dass eine Zeile Code geändert wurde.
5.10Wo endliche Automaten scheitern
Diesen Abschnitt als PDF (S. 21–22)
Die Chomsky-Hierarchie und die Beispiele nicht-regulärer und nicht-kontextfreier Sprachen stehen nur im LK-Lehrplan. Im Grundkurs genügt die Einsicht aus dem ersten Absatz: Der Zustand eines endlichen Automaten ist sein ganzes Gedächtnis, und das ist endlich.
Ein Türsteher soll am Ende des Abends sagen, ob alle Gäste wieder draußen sind. Mit einer Strichliste ist das leicht. Darf er sich aber nur merken, ob „wenig“, „mittel“ oder „viel“ los ist, kann er es nicht — egal, wie aufmerksam er ist. Genau in dieser Lage ist ein endlicher Automat: Er hat nur endlich viele Zustände, die Gästeschlange ist aber beliebig lang.
Konstruieren Sie einen Automaten, der genau die Wörter akzeptiert, also , , und so weiter — gleich viele wie .
Es gelingt nicht, und der Grund ist grundsätzlich: Der Automat müsste sich merken, wie viele er gelesen hat, bevor das erste kommt. Diese Zahl ist unbeschränkt, seine Zustandsmenge aber endlich. Bei genügend langer Eingabe muss er zwangsläufig zweimal in denselben Zustand geraten, obwohl er unterschiedlich viele gesehen hat — und dann kann er die beiden Fälle nicht mehr unterscheiden.
Dasselbe gilt für die Klammersprache aus 5.4: Verschachtelte Klammern erfordern ein unbeschränktes Gedächtnis. Genau deshalb war jene Grammatik nicht regulär.
Eine Maschine, die sehr wohl erkennt, kennen Sie schon: die Turingmaschine aus Abschnitt 1.2. Sie streicht Paare durch und schreibt sich die Zwischenstände aufs Band. Der Unterschied ist genau dieser Schreibplatz — der endliche Automat hat keinen.
Endliche Automaten erkennen genau die regulären Sprachen. Alles, was Zählen oder Schachteln erfordert, liegt außerhalb.
Für solche Sprachen braucht man mächtigere Maschinen. Ein Kellerautomat besitzt zusätzlich einen Stapelspeicher: Bei jedem legt er eine Marke ab, bei jedem nimmt er eine weg — und akzeptiert, wenn der Stapel am Ende leer ist. Damit erkennt er die kontextfreien Sprachen, zu denen auch die Klammerstrukturen der Programmiersprachen gehören. Ganz oben steht die Turingmaschine aus Abschnitt 1.2. Diese Staffelung heißt Chomsky-Hierarchie:
| Typ | Sprachklasse | Maschine | Form der Produktionen | Beispiel |
|---|---|---|---|---|
| 3 | regulär | endlicher Automat | oder | Bezeichner, Zahlen |
| 2 | kontextfrei | Kellerautomat | (links ein Nichtterminal) | , Klammern |
| 1 | kontextsensitiv | linear beschränkter Automat | mit | |
| 0 | rekursiv aufzählbar | Turingmaschine | beliebig | haltende Programme |
In Worten, von der schwächsten zur mächtigsten Stufe:
- Typ 3, regulär. Das Gedächtnis ist endlich. Die Maschine merkt sich eine von endlich vielen Lagen, sonst nichts. Sie kann erkennen, dass etwas vorkam, aber nicht, wie oft.
- Typ 2, kontextfrei. Dazu kommt ein Stapel. Damit lässt sich zählen und schachteln, aber immer nur eine Sache zur Zeit — was heruntergenommen ist, ist weg.
- Typ 1, kontextsensitiv. Der Speicher wächst mit der Eingabe. Jede Regel darf die Satzform nur verlängern, nie verkürzen; deshalb bleibt die Wortfrage entscheidbar.
- Typ 0, rekursiv aufzählbar. Keine Beschränkung mehr. Das ist genau das, was eine Turingmaschine aufzählen kann — und hier wird die Wortfrage unentscheidbar: Gehört das Wort zur Sprache, hält die Maschine irgendwann und sagt ja; gehört es nicht dazu, läuft sie möglicherweise für immer. Das ist genau die partielle Entscheidbarkeit aus Abschnitt 4.4. „Rekursiv aufzählbar” ist deshalb nicht dasselbe wie „berechenbar”.
Die vier Klassen sind echt ineinander geschachtelt — jede Stufe kann alles, was die vorige kann, und mehr:
Zwei Beispiele markieren die beiden Sprünge, die in der Schule am häufigsten gebraucht werden:
ist nicht regulär, aber kontextfrei. Der Grund steht oben: Ein endlicher Automat kann die nicht zählen, ein Kellerautomat schon.
ist nicht kontextfrei, aber kontextsensitiv. Hier reicht auch der Stapel nicht: Beim Abarbeiten der wird er geleert — für die ist die Zahl der dann verloren. Man müsste zweimal dasselbe zählen, und dafür braucht es ein Band statt eines Stapels.
Das erklärt nebenbei den Aufbau eines Compilers: Der Lexer erkennt Token — die sind regulär, ein endlicher Automat genügt. Der Parser prüft die Struktur — die ist kontextfrei und braucht einen Stapel.
- Versuchen Sie, einen Automaten für mit höchstens fünf Zuständen zu bauen. Beschreiben Sie, woran es scheitert, und geben Sie ein Wort an, das Ihr Automat fälschlich akzeptiert.
- Begründen Sie, warum ein Automat mit 100 Zuständen die Sprache für korrekt entscheiden kann — und warum das nichts nützt.
- Ordnen Sie ein: Telefonnummern, korrekt geklammerte Terme, Datumsangaben im Format TT.MM.JJJJ, vollständige Pascal-Programme.
Lösung vergleichen
- Ein naheliegender Versuch: Zustände
,
(„nur
gelesen“),
(„
und danach
gelesen“, Endzustand) und ein Fehlerzustand. Er prüft nur die Form
,
nicht die Anzahl —
aabwird fälschlich akzeptiert. Das gilt für jeden Versuch mit fünf Zuständen: Unter den sechs Wörtern müssen zwei, etwa und mit , im selben Zustand enden. Dann behandelt der Automat genauso wie und akzeptiert es — obwohl es nicht zur Sprache gehört. - Der Automat kann für jede Zahl von bis 40 einen eigenen Zustand haben (41 Zustände), dann für jeden noch fehlenden Rest an einen (40 Zustände, der letzte ist Endzustand), dazu einen Fehlerzustand — 82 Zustände, das passt in 100. Nur nützt es nichts: Die Sprache ist unendlich. gehört dazu und wird abgelehnt, und jede größere Schranke hat dasselbe Problem.
- Telefonnummern: regulär — Ziffern, Trennzeichen, feste Muster. Korrekt geklammerte Terme: kontextfrei, nicht regulär — man muss die Schachtelung zählen. Datumsangaben TT.MM.JJJJ: regulär, es gibt sogar nur endlich viele. Vollständige Pascal-Programme: Die Syntax ist kontextfrei, dafür ist der Parser zuständig. Bedingungen wie „jede Variable ist vorher deklariert“ gehen darüber hinaus; der Compiler prüft sie in einem eigenen Schritt.
5.11Reguläre Ausdrücke in der Praxis
Diesen Abschnitt als PDF (S. 23)
Reguläre Ausdrücke stehen in keinem der beiden Lehrpläne. Sie sind hier aufgenommen, weil sie dieselbe Sprachklasse beschreiben wie Grammatik und Automat — und weil sie das einzige Werkzeug dieses Kapitels sind, das Ihnen im Alltag jede Woche begegnet.
Sie wollen in einem Chatverlauf alle Nachrichten finden, in denen
eine Uhrzeit steht, egal ob 7:30 oder 18:05. Die normale Suche verlangt
jede Uhrzeit einzeln. Ein regulärer Ausdruck beschreibt stattdessen das
Muster einmal: [0-9]+:[0-9][0-9] — eine oder mehr
Ziffern, ein Doppelpunkt, zwei Ziffern. Er benutzt nur Bausteine aus der
Tabelle dieses Abschnitts.
Was in 5.5 als Grammatik und in 5.6 als Automat auftrat, schreibt man im Alltag als regulären Ausdruck. Editoren, Suchfunktionen, Formularprüfungen und Logauswertungen benutzen sie täglich.
| Ausdruck | Bedeutung | passt auf |
|---|---|---|
abb |
genau diese Folge | abb |
a* |
beliebig viele , auch keines | ε, a, aaa |
a+ |
mindestens ein | a, aaa |
a? |
höchstens ein | ε, a |
[a-z] |
ein Zeichen aus dem Bereich | k |
(ab)+ |
Wiederholung der Gruppe | ab, ababab |
a|b |
Alternative | a oder b |
Ein Bezeichner ist damit [A-Za-z][A-Za-z0-9]*, eine
Dualzahl ohne führende Null 1[01]*, eine gerade Dualzahl
1[01]*0.
import re

muster = re.compile(r"[A-Za-z][A-Za-z0-9]*$")
for text in ["zaehler", "2fast", "x1", "mein wert"]:
    print(text, bool(muster.match(text)))
Unter der Haube übersetzt die Bibliothek den Ausdruck in einen endlichen Automaten — und läuft ihn genau so ab, wie Sie es in 5.9 programmiert haben.
- Schreiben Sie reguläre Ausdrücke für: Wörter über
mit
aa; ungerade Dualzahlen; deutsche Postleitzahlen; eine E-Mail-Adresse in grober Näherung. - Prüfen Sie mit dem Python-Beispiel Ihre Ausdrücke aus Aufgabe 44.
- Begründen Sie, warum sich mit regulären Ausdrücken nicht prüfen lässt, ob in einem Term gleich viele öffnende wie schließende Klammern stehen.
Lösung vergleichen
gesucht regulärer Ausdruck Wörter über mit aa[ab]*aa[ab]*ungerade Dualzahlen 1|1[01]*1deutsche Postleitzahlen [0-9]{5}E-Mail-Adresse (grob) [\w.-]+@[\w.-]+\.[a-z]+{5}heißt „genau fünfmal“,\wsteht für einen Buchstaben, eine Ziffer oder_.Damit der Ausdruck den ganzen Text erfassen muss, verwendet man
fullmatch:import re muster = re.compile(r"[0-9]{5}") for text in ["66564", "01067", "6656", "123456", "D-66564"]: print(text, bool(muster.fullmatch(text)))Die ersten beiden ergeben
True, die übrigenFalse. Mitmatchund ohne$am Ende würde auch123456durchgehen — der Anfang passt ja.Ein regulärer Ausdruck beschreibt eine reguläre Sprache, und dazu gibt es einen endlichen Automaten. Um gleich viele öffnende wie schließende Klammern zu prüfen, müsste er sich unbeschränkt viele offene Klammern merken. Mit endlich vielen Zuständen geht das nicht — dasselbe Argument wie bei .
5.12Zusammenfassung
Diesen Abschnitt als PDF (S. 24)
- Syntax beschreibt die Form, Semantik die Bedeutung. Maschinen prüfen zuverlässig nur die Form.
- Ein Alphabet ist eine endliche Zeichenmenge, die Menge aller Wörter darüber, eine formale Sprache eine Teilmenge von .
- Eine Grammatik erzeugt Wörter durch Ableitungen; sie ist regulär, wenn jede rechte Seite aus genau einem Terminalzeichen und höchstens einem Nichtterminal dahinter besteht.
- Ein endlicher Automat erkennt Wörter. Sein Zustand ist sein gesamtes Gedächtnis.
- Reguläre Grammatik, endlicher Automat und regulärer Ausdruck beschreiben dieselbe Sprachklasse und lassen sich ineinander überführen.
- Nichtdeterminismus verkürzt Diagramme, erweitert aber die Sprachklasse nicht.
- Zählen und Schachteln liegen außerhalb der regulären Sprachen; dafür braucht es Kellerautomaten und die höheren Stufen der Chomsky-Hierarchie.
Wiederholungsaufgaben
- Erklären Sie die vier Bestandteile einer Grammatik an einem selbst gewählten Beispiel.
- Geben Sie zur Sprache „alle Wörter über , die mit 0 beginnen und auf 1 enden” eine reguläre Grammatik, einen DEA und einen regulären Ausdruck an.
- Wandeln Sie den Automaten aus Aufgabe 48 in eine Grammatik zurück und prüfen Sie, ob Sie dieselbe Sprache erhalten.
- Erklären Sie einem Mitschüler in fünf Sätzen, warum ein endlicher Automat keine Klammern prüfen kann.
- Welche Teile eines Compilers arbeiten mit endlichen Automaten, welche mit Grammatiken? Begründen Sie.