Kapitel 4
Sprachmodelle
Skript Informatik · Klasse 10 · MINT
Notebooks in diesem Kapitel DS30–DS34
- DS30 Sprachmodelle: Regeln oder Statistik?
- DS31 n-Gramme zählen: ein Sprachmodell von Hand trainieren
- DS32 Textanalyse mit dem Computer
- DS33 Texte erzeugen: next word prediction und Sampling
- DS34 Halluzinationen, moderne KI und die Arbeitswelt
Alle Notebooks der Klasse · Das grüne Schild an einer Überschrift zeigt, zu welchem Notebook der Abschnitt gehört.
PDF zum Ausdrucken zusammenstellen
Kreuze an, welche Abschnitte du brauchst. Die PDF hat dasselbe Aussehen wie das gedruckte Skript, mit Platz zum Schreiben. Jeden Abschnitt gibt es auch einzeln unter seiner Überschrift, das ganze Kapitel unten auf der Seite.
Chatbots schreiben Aufsätze, beantworten Fragen und übersetzen Texte. Doch wie kann ein Computer Sätze bilden, die so klingen, als hätte ein Mensch sie geschrieben? In diesem Kapitel findest du es heraus – an einem einfachen Modell, das du vollständig verstehen und sogar von Hand nachrechnen kannst: dem n-Gramm-Modell. Damit erklärst du auch, warum solche Systeme manchmal überzeugend klingende, aber falsche Dinge schreiben.
Das erwartet dich in diesem Kapitel:
- Regeln oder Statistik? – vom regelbasierten Chatbot ELIZA zu statistischen Sprachmodellen.
- n-Gramme zählen – ein kleines Sprachmodell von Hand trainieren.
- Textanalyse mit dem Computer – größere Texte mit Python auszählen.
- Texte erzeugen – Wort für Wort mit next word prediction und verschiedenen Sampling-Strategien.
- Halluzinationen, moderne KI und die Arbeitswelt – warum Sprachmodelle Falsches erfinden, was moderne Chatbots anders machen und wie KI Berufe verändert.
Mit diesen Satzanfängen beschreibst und begründest du deine Ergebnisse in diesem Kapitel:
- „Auf den Kontext … folgt mit der Häufigkeit/Wahrscheinlichkeit … das Wort …“
- „Der erzeugte Text verändert sich, weil …“
- „Im Vergleich zum n-Gramm-Modell kann das LLM …, jedoch …“
Am Ende hilft dir ein Rückblick mit den wichtigsten Begriffen und einem Kompetenz-Check beim Wiederholen.
4.1Sprachmodelle: Regeln oder Statistik? DS30
Diesen Abschnitt als PDF (S. 2–15)
Das Jupyter-Notebook aus dem Unterricht: DS30_Sprachmodelle_Regelbasiert_vs_nGramm.ipynb. Herunterladen und in VS Code oder Jupyter öffnen.
Du schreibst einem Chatbot eine Frage, und Sekunden später steht eine Antwort da, die klingt, als hätte ein Mensch sie geschrieben. Aber woher „weiß“ das Programm, was es antworten soll? Es gibt dafür zwei grundverschiedene Ideen. Die erste: Menschen schreiben Regeln auf, nach denen das Programm reagiert. Die zweite: Das Programm zählt in sehr vielen Texten, welche Wörter oft aufeinanderfolgen, und rechnet damit. In diesem Abschnitt lernst du beide Ideen kennen. Du programmierst einen kleinen Gesprächspartner nach festen Regeln und findest heraus, wo seine Grenzen liegen.
Nach diesem Abschnitt kannst du
- erläutern, was ein Sprachmodell ist,
- beschreiben, wie ein regelbasiertes System wie ELIZA funktioniert,
- ein kleines regelbasiertes Programm in Python testen und um eigene Regeln erweitern,
- die Grundidee eines n-Gramm-Modells beschreiben,
- regelbasierte Systeme und n-Gramm-Modelle unterscheiden und ihre Grenzen benennen.
4.1.1Was ist ein Sprachmodell?
Menschen lernen Sprache, indem sie zuhören, lesen und sprechen. Dabei bekommst du mit der Zeit ein Gefühl dafür, welche Wörter zusammenpassen. Lies den folgenden Satzanfang:
Ich trinke morgens eine Tasse …
Wahrscheinlich hast du sofort „Kaffee“ oder „Tee“ ergänzt – und nicht „Fahrrad“. Niemand hat dir dafür eine Regel beigebracht. Du hast diesen Satzanfang einfach schon sehr oft mit genau diesen Wörtern gehört oder gelesen.
Ein Computer kann so etwas nicht „fühlen“. Man kann ihm aber ein Modell der Sprache mitgeben: eine vereinfachte Beschreibung, wie Sätze aufgebaut sind und welche Wörter wie oft zusammen vorkommen. Damit kann ein Programm Texte untersuchen oder selbst neue Texte erzeugen. So ein Programm heißt Sprachmodell.
Ein Sprachmodell ist ein Computersystem, das ein vereinfachtes Modell einer Sprache enthält: wie Sätze aufgebaut sind und wie wahrscheinlich bestimmte Wortfolgen sind. Damit kann es Texte untersuchen oder neue Texte erzeugen.
Das Wort Wahrscheinlichkeit kennst du aus Mathe: Sie gibt an, wie sicher ein Ereignis eintritt, als Zahl zwischen 0 und 1 oder in Prozent. Bei Sprachmodellen geht es zum Beispiel um die Frage: Wie wahrscheinlich ist es, dass nach „eine Tasse“ das Wort „Tee“ folgt?
Sprachmodelle gibt es schon seit Jahrzehnten. Historisch gab es zwei wichtige Ansätze, die du in diesem Abschnitt kennenlernst: regelbasierte Systeme und n-Gramm-Modelle. Die heutigen großen Chatbots bauen auf dem zweiten Ansatz auf.
Ein Sprachmodell ist ein System, das sprachliche Strukturen bzw. Wahrscheinlichkeiten erfasst, um Texte zu analysieren oder neu zu erzeugen.
4.1.2Regelbasierte Systeme: ELIZA
Ein Programm, das zuhört – scheinbar
Im Jahr 1966 veröffentlichte der Informatiker Joseph Weizenbaum am Massachusetts Institute of Technology (MIT) in den USA ein Programm namens ELIZA. Man konnte ihm Sätze eintippen, und es antwortete. In seiner bekanntesten Fassung spielte ELIZA eine Psychotherapeutin, die vor allem Rückfragen stellt. Ein Gespräch konnte etwa so aussehen:
Mensch:  Ich fühle mich müde.
ELIZA:   Warum fühlst du dich müde?
Mensch:  Ich brauche mehr Schlaf.
ELIZA:   Warum brauchst du mehr Schlaf?
Das wirkt, als würde ELIZA zuhören und mitdenken. Tatsächlich versteht das Programm kein einziges Wort. Es sucht im eingegebenen Satz nach bestimmten Mustern, zum Beispiel nach „Ich fühle mich“. Findet es ein Muster, setzt es den Rest des Satzes in eine vorbereitete Antwort ein. Weizenbaum war erschrocken, wie ernst manche Menschen das Programm trotzdem nahmen und ihm persönliche Dinge anvertrauten.
Das Wissen von ELIZA steckt also vollständig in Regeln, die ein
Mensch vorher aufgeschrieben hat. Jede Regel hat die Form „Wenn
…, dann …“ – genau wie eine Verzweigung mit if in
Python.
Ein regelbasiertes System reagiert nach fest programmierten Regeln. Es erkennt Muster in der Eingabe (z. B. bestimmte Wörter) und gibt die Antwort aus, die für dieses Muster vorgesehen ist.
Regelbasierte Systeme (z. B. das historische Programm ELIZA, 1966) reagieren auf Basis fest programmierter Regeln und Mustererkennung, z. B.: „Wenn der Satz ‚Ich fühle mich …‘ enthält, antworte mit ‚Warum fühlst du dich …?’“. Sie „verstehen“ die Sprache nicht, sondern wenden feste Muster an.
Ein Werkzeug: Textteile ersetzen
Für unser eigenes kleines ELIZA brauchst du ein neues Werkzeug. Aus dem Satz „ich fühle mich müde“ soll das Programm den Rest „müde“ herausholen. Das geht, indem man den Anfang „ich fühle mich “ durch nichts ersetzt.
Mit text.replace(alt, neu) erhältst du eine Kopie von
text, in der jedes Vorkommen von alt durch
neu ersetzt ist. Der ursprüngliche Text bleibt unverändert.
Ersetzt du durch die leere Zeichenkette "", wird der Teil
einfach entfernt:
satz = "ich fühle mich müde"
print(satz.replace("fühle", "bin"))
print(satz.replace("ich fühle mich ", ""))
ich bin mich müde
müdeAchte auf das Leerzeichen am Ende von "ich fühle mich ".
Ohne dieses Leerzeichen würde der Rest mit einem Leerzeichen beginnen:
" müde".
Ein Mini-ELIZA in Python
Das folgende Programm ist ein stark vereinfachtes ELIZA. Es kennt nur vier Regeln:
| Wenn der Satz … enthält | antwortet Mini-ELIZA |
|---|---|
| „ich fühle mich …“ | „Warum fühlst du dich …?“ |
| „ich brauche …“ | „Warum brauchst du …?“ |
| ein Fragezeichen | „Interessante Frage - was denkst du selbst darüber?“ |
| sonst | „Erzähl mir mehr davon.“ |
Die Regeln werden von oben nach unten geprüft. Die erste passende
Regel gewinnt. Im Programm wird daraus eine Funktion mit
if, elif und else:
def mini_eliza(satz):
    satz = satz.lower()
    if "ich fühle mich" in satz:
        gefuehl = satz.replace("ich fühle mich ", "")
        return f"Warum fühlst du dich {gefuehl}?"
    elif "ich brauche" in satz:
        bedarf = satz.replace("ich brauche ", "")
        return f"Warum brauchst du {bedarf}?"
    elif "?" in satz:
        return "Interessante Frage - was denkst du selbst darüber?"
    else:
        return "Erzähl mir mehr davon."

print(mini_eliza("Ich fühle mich müde"))
print(mini_eliza("Ich brauche mehr Zeit"))
print(mini_eliza("Wie geht es dir?"))
print(mini_eliza("Die Sonne scheint"))
Warum fühlst du dich müde?
Warum brauchst du mehr zeit?
Interessante Frage - was denkst du selbst darüber?
Erzähl mir mehr davon.- Zeile 1: Die Funktion
mini_elizabekommt einen Satz als Parameter und gibt eine Antwort mitreturnzurück. - Zeile 2: Der Satz wird in Kleinbuchstaben umgewandelt. So erkennt das Programm „Ich fühle mich“ und „ich fühle mich“ gleichermaßen.
- Zeilen 3–5: Die erste Regel. Steht „ich fühle mich“ im Satz, wird dieser Teil entfernt. Was übrig bleibt (hier „müde“), wird mit einem f-String in die Antwort eingesetzt.
- Zeilen 6–8: Die zweite Regel funktioniert genauso mit „ich brauche“.
- Zeilen 9–10: Enthält der Satz ein Fragezeichen, kommt eine allgemeine Antwort, die zum Nachdenken auffordert.
- Zeilen 11–12: Passt keine Regel, antwortet das Programm mit einem Satz, der fast immer irgendwie passt.
- Zeilen 14–17: Vier Testsätze. Für jeden wird die Antwort ausgegeben.
Schau dir die zweite Ausgabezeile genau an: „mehr zeit“ ist kleingeschrieben. Das Programm hat den ganzen Satz in Zeile 2 kleingeschrieben und setzt den Rest unverändert ein. Ein Mensch würde diesen Fehler nie machen. Das Programm merkt ihn nicht, denn es weiß nicht, dass „Zeit“ ein Nomen ist.
Tippe das Programm ab und teste es mit eigenen Sätzen. Ändere auch die Reihenfolge der Regeln: Was antwortet das Programm auf „Ich fühle mich gut, und du?“, wenn die Regel mit dem Fragezeichen ganz oben steht?
Wenn du mini_eliza mit print aufrufst und
statt einer Antwort None erscheint, fehlt in einem Zweig
das return. Dann gibt die Funktion nichts zurück. Prüfe, ob
in jedem Zweig (if, elif,
else) eine return-Anweisung steht.
Wo die Regeln an ihre Grenzen stoßen
Mini-ELIZA wirkt nur dann klug, wenn der Satz genau zu einem Muster
passt. Schon kleine Änderungen bringen es aus dem Tritt. Die Funktion
mini_eliza von oben wird hier mit zwei neuen Sätzen
aufgerufen:
print(mini_eliza("Heute fühle ich mich müde"))
print(mini_eliza("Ich brauche dich"))
Erzähl mir mehr davon.
Warum brauchst du dich?Im ersten Satz stehen die Wörter in anderer Reihenfolge („fühle ich mich“). Das Muster passt nicht, und das Programm weicht auf seine Allerweltsantwort aus. Im zweiten Satz passt das Muster, aber das Programm übernimmt „dich“ wörtlich. Richtig wäre „Warum brauchst du mich?“. Um das zu können, müsste das Programm wissen, wer mit „dich“ gemeint ist. Das weiß es nicht.
Natürlich könnte man für jeden dieser Fälle eine weitere Regel schreiben. Aber Sprache ist unglaublich vielfältig: Es gibt unzählige Arten, dasselbe zu sagen. Man müsste unüberschaubar viele Regeln schreiben – und die Regeln dürfen sich nicht widersprechen.
Teste mini_eliza mit mindestens drei eigenen
Sätzen, die nicht zu den vorgesehenen Mustern
passen oder bei denen eine seltsame Antwort entsteht. Notiere Satz und
Antwort. Beschreibe jeweils, warum das System hier keine sinnvolle
Antwort liefern kann.
Meine Testsätze, Antworten und Erklärungen:
Lösung vergleichen
Zum Beispiel (mit der Funktion mini_eliza aus dem
Abschnitt Ein Mini-ELIZA in Python):
print(mini_eliza("Mir geht es heute gar nicht gut"))
print(mini_eliza("Ich glaube, ich fühle mich krank"))
print(mini_eliza("Ich brauche keine Hilfe, danke"))
print(mini_eliza("Ich fühle mich gut. Und du?"))
Erzähl mir mehr davon.
Warum fühlst du dich ich glaube, krank?
Warum brauchst du keine hilfe, danke?
Warum fühlst du dich gut. und du??- „Mir geht es heute gar nicht gut“ bedeutet fast dasselbe wie „Ich fühle mich schlecht“. Es gibt aber keine Regel für diese Formulierung. Das Programm erkennt die Bedeutung nicht und antwortet allgemein.
- Bei „Ich glaube, ich fühle mich krank“ wird nur „ich fühle mich “ entfernt. Der Satzanfang „ich glaube,“ bleibt stehen und landet unsinnig in der Antwort.
- Bei „Ich brauche keine Hilfe, danke“ passt die Regel, aber die Antwort ist unpassend: Der Mensch hat gerade gesagt, dass er nichts braucht.
- Der letzte Satz passt auf zwei Regeln. Weil die Regel mit „ich fühle mich“ zuerst geprüft wird, wird die Frage „Und du?“ nicht beantwortet, sondern einfach mit in die Antwort kopiert.
Worauf es ankommt: Das Programm prüft nur, ob eine bestimmte Zeichenfolge im Satz steht. Es kennt keine Bedeutung, keine Grammatik und keinen Zusammenhang. Jeder Satz, für den niemand eine passende Regel geschrieben hat, führt zu einer unpassenden Antwort.
Erweitere mini_eliza um mindestens eine weitere
Regel deiner Wahl, zum Beispiel eine Reaktion auf „Ich mag …“
oder „Ich hasse …“. Nenne die neue Funktion
mini_eliza_erweitert und teste sie mit passenden
Sätzen.
Lösung vergleichen
def mini_eliza_erweitert(satz):
    satz = satz.lower()
    if "ich fühle mich" in satz:
        gefuehl = satz.replace("ich fühle mich ", "")
        return f"Warum fühlst du dich {gefuehl}?"
    elif "ich brauche" in satz:
        bedarf = satz.replace("ich brauche ", "")
        return f"Warum brauchst du {bedarf}?"
    elif "ich mag" in satz:
        sache = satz.replace("ich mag ", "")
        return f"Was gefällt dir an {sache}?"
    elif "ich hasse" in satz:
        sache = satz.replace("ich hasse ", "")
        return f"Seit wann hasst du {sache}?"
    elif "?" in satz:
        return "Interessante Frage - was denkst du selbst darüber?"
    else:
        return "Erzähl mir mehr davon."

print(mini_eliza_erweitert("Ich mag Mathe"))
print(mini_eliza_erweitert("Ich hasse Montage"))
print(mini_eliza_erweitert("Ich fühle mich müde"))
Was gefällt dir an mathe?
Seit wann hasst du montage?
Warum fühlst du dich müde?Jede neue Regel ist ein weiterer elif-Zweig mit
derselben Bauweise: Muster prüfen, Muster entfernen, Rest in die Antwort
einsetzen. Die neuen Zweige müssen vor dem
else stehen, sonst werden sie nie erreicht. Wichtig ist
auch, dass die alten Testsätze noch richtig beantwortet werden.
4.1.3n-Gramm-Modelle: Statistik statt Regeln
Die Idee: Zählen, was oft zusammen vorkommt
Erinnere dich an den Satzanfang „Ich trinke morgens eine Tasse …“. Du hast das fehlende Wort nicht mit einer Regel gefunden, sondern aus Erfahrung: Nach „eine Tasse“ kam in deinem Leben oft „Kaffee“ oder „Tee“.
Genau diese Idee nutzt ein n-Gramm-Modell. Statt Regeln aufzuschreiben, gibt man dem Computer sehr viele Texte. Er zählt, welche Wörter wie oft direkt hintereinander stehen. Eine solche Folge von aufeinanderfolgenden Wörtern heißt n-Gramm. Das n steht für die Anzahl der Wörter: Ein Wortpaar wie „eine Tasse“ ist ein 2-Gramm, man sagt auch Bigramm.
Ein ganz kleines Beispiel. Der Computer bekommt diese drei Sätze als Trainingstext:
ich trinke eine tasse tee
ich trinke eine tasse kaffee
ich trinke eine tasse tee
Nach dem Wort „tasse“ folgt zweimal „tee“ und einmal „kaffee“. Soll das Modell den Satz „ich trinke eine tasse …“ fortsetzen, ist „tee“ das wahrscheinlichste nächste Wort. Das Modell hat keine Regel über Getränke gelernt. Es hat nur gezählt.
Diese Vorhersage des nächsten Wortes heißt auf Englisch next word prediction. Die Wortvorschläge, die dir beim Tippen auf dem Handy über der Tastatur angezeigt werden, beruhen auf einer ähnlichen Idee: Das Programm schlägt Wörter vor, die nach dem bisher Getippten wahrscheinlich sind.
Ein n-Gramm-Modell ist ein Sprachmodell, das aus einer großen Textsammlung zählt, wie häufig bestimmte Folgen von Wörtern (n-Gramme) vorkommen. Aus diesen Häufigkeiten berechnet es, welches Wort wahrscheinlich als nächstes folgt.
n-Gramm-Modelle basieren auf der statistischen Analyse großer Textmengen: Sie erfassen, wie häufig bestimmte Wortfolgen (n-Gramme) in einer Textsammlung vorkommen, und nutzen diese Häufigkeiten zur Vorhersage des nächsten Wortes.
Wie man n-Gramme genau zählt und daraus Wahrscheinlichkeiten berechnet, lernst du im nächsten Abschnitt – zuerst von Hand, dann mit Python.
Und die modernen Chatbots?
Die Chatbots, die du vielleicht kennst, beruhen auf sogenannten Large Language Models, kurz LLMs (englisch für „große Sprachmodelle“). Sie wurden mit riesigen Textmengen trainiert und benutzen sehr komplexe Rechenverfahren, sogenannte neuronale Netze. Wie diese im Einzelnen funktionieren, ist nicht Thema dieses Skripts. Die Grundidee ist aber dieselbe wie beim n-Gramm-Modell: Ein LLM schätzt, welches Wort (genauer: welcher Wortbaustein) als nächstes am wahrscheinlichsten passt, hängt es an und wiederholt das immer wieder.
Moderne Large Language Models (LLMs) nutzen komplexe neuronale Netze, beruhen aber im Kern auf einem ähnlichen Prinzip: Sie schätzen Wahrscheinlichkeiten für die Fortsetzung eines Textes.
Deshalb lohnt es sich, das n-Gramm-Modell genau zu verstehen. An ihm kannst du vollständig nachrechnen, was im Inneren passiert – bei einem LLM ist das nicht mehr möglich.
4.1.4Regeln und Statistik im Vergleich
Die beiden Ansätze unterscheiden sich vor allem darin, woher das Wissen des Systems kommt:
| regelbasiertes System | n-Gramm-Modell | |
|---|---|---|
| Woher kommt das Wissen? | Ein Mensch schreibt Regeln auf. | Der Computer zählt in Texten. |
| Was steht im Programm? | „Wenn …, dann …“-Regeln | Tabellen mit Häufigkeiten |
| Neue Formulierungen | nur, wenn eine Regel passt | möglich, wenn ähnliche Wortfolgen im Text vorkamen |
| Verhalten nachvollziehbar? | ja, jede Antwort folgt aus einer Regel | ja, jede Wahl folgt aus den Zahlen |
| Versteht es die Bedeutung? | nein | nein |
Die letzte Zeile ist wichtig: Keines der beiden Systeme versteht, was es schreibt. Das regelbasierte System erkennt Zeichenfolgen, das n-Gramm-Modell rechnet mit Häufigkeiten.
So beschreibst du die Ansätze in Fachsprache – vom einfachen zum genauen Satz:
- „ELIZA hat Wenn-dann-Sätze.“ → „ELIZA ist ein regelbasiertes System: Es erkennt Muster in der Eingabe und reagiert nach fest programmierten Regeln.“
- „Das Modell guckt, was oft kommt.“ → „Das n-Gramm-Modell ermittelt aus einer Textsammlung, wie häufig Wortfolgen vorkommen, und sagt daraus das wahrscheinlichste nächste Wort voraus.“
- „Der Chatbot versteht nichts.“ → „Das System verarbeitet Zeichenfolgen bzw. Häufigkeiten, ohne die Bedeutung der Wörter zu erfassen.“
4.1.5Übungen
Entscheide jeweils, ob das beschriebene Programm regelbasiert arbeitet oder nach dem Prinzip eines n-Gramm-Modells. Begründe in einem Satz.
- Ein Programm antwortet auf jede E-Mail, die das Wort „Urlaub“ enthält, mit „Ich bin bis Montag nicht erreichbar.“
- Ein Programm schlägt beim Tippen das Wort vor, das in einer großen Sammlung von Nachrichten am häufigsten nach dem zuletzt getippten Wort stand.
- Ein Spiel-Chatbot erkennt die Wörter „hallo“, „tschüss“ und „hilfe“ und hat für jedes eine feste Antwort.
- Ein Programm zählt in allen Märchen der Brüder Grimm, welches Wort wie oft nach „es war“ folgt, und ergänzt damit angefangene Sätze.
Meine Antworten:
Lösung vergleichen
- Regelbasiert: Die Regel „Wenn ‚Urlaub‘ vorkommt, dann sende diesen Text“ wurde von einem Menschen festgelegt.
- n-Gramm-Modell: Das Programm nutzt die Häufigkeit von Wortpaaren (Bigrammen) in einer Textsammlung.
- Regelbasiert: Feste Schlüsselwörter mit fest zugeordneten Antworten – wie bei Mini-ELIZA.
- n-Gramm-Modell: Es wird gezählt, wie oft Wortfolgen vorkommen. Weil der Kontext „es war“ aus zwei Wörtern besteht, zählt das Programm Folgen aus drei Wörtern (Trigramme).
Erkennungsmerkmal: Wird etwas gezählt und nach Häufigkeit ausgewählt, ist es ein statistisches Modell. Steht eine feste Wenn-dann-Zuordnung dahinter, ist es regelbasiert.
Beantworte schriftlich:
- Warum stößt ein rein regelbasiertes System bei der Vielfalt natürlicher Sprache schnell an Grenzen?
- Welchen grundsätzlich anderen Ansatz verfolgen n-Gramm-Modelle (Stichwort: Regeln oder Statistik)?
Diese Fragen werden in den nächsten Abschnitten praktisch vertieft.
Meine Antwort:
Lösung vergleichen
- Ein regelbasiertes System kann nur auf Eingaben sinnvoll reagieren, für die ein Mensch vorher eine Regel geschrieben hat. Natürliche Sprache ist aber sehr vielfältig: Derselbe Gedanke lässt sich auf unzählige Arten ausdrücken („Ich fühle mich schlecht“, „Mir geht es nicht gut“, „Heute ist echt ein mieser Tag“). Man bräuchte unüberschaubar viele Regeln, die sich außerdem nicht widersprechen dürfen. Sobald keine Regel passt oder die falsche Regel greift, entsteht eine unpassende Antwort.
- n-Gramm-Modelle arbeiten statistisch: Statt Regeln vorzugeben, wertet man eine große Textsammlung aus und zählt, wie oft Wortfolgen vorkommen. Aus diesen Häufigkeiten ergibt sich, welches Wort wahrscheinlich als nächstes folgt. Das Wissen wird also aus Daten gewonnen und nicht von Menschen als Regel formuliert.
Worauf es ankommt: „Regeln von Menschen“ gegen „Häufigkeiten aus Texten“ – und der Hinweis, dass beide Systeme die Bedeutung nicht verstehen.
4.1.6Weitere Übungen
Hier kannst du das Gelernte weiter üben. Die Punkte im Titel zeigen, wie schwer eine Aufgabe ist: ●○○ leicht, ●●○ mittel, ●●● knifflig. Fang mit den leichten an.
Entscheide, ob die Aussage richtig oder falsch ist. Trage „r“ oder „f“ ein. Verbessere die falschen Aussagen unten in einem Satz.
| Nr. | Aussage | r oder f? |
|---|---|---|
| 1 | Ein Sprachmodell erfasst sprachliche Strukturen bzw. Wahrscheinlichkeiten, um Texte zu analysieren oder zu erzeugen. | |
| 2 | ELIZA versteht die Bedeutung der Sätze, die man eintippt. | |
| 3 | Ein regelbasiertes System reagiert nach Regeln, die vorher fest programmiert wurden. | |
| 4 | Ein n-Gramm-Modell zählt in Texten, wie oft bestimmte Wortfolgen vorkommen. | |
| 5 | Ein n-Gramm-Modell braucht für jede mögliche Eingabe eine eigene Wenn-dann-Regel. | |
| 6 | Moderne LLMs arbeiten ganz anders als n-Gramm-Modelle: Sie schätzen keine Wahrscheinlichkeiten. |
Verbesserungen:
Lösung vergleichen
| Nr. | r oder f? | Verbesserung |
|---|---|---|
| 1 | r | – |
| 2 | f | ELIZA versteht nichts. Es erkennt nur Muster (z. B. „ich fühle mich“) und wendet feste Regeln an. |
| 3 | r | – |
| 4 | r | – |
| 5 | f | Das gilt für regelbasierte Systeme. Ein n-Gramm-Modell nutzt Häufigkeiten aus Texten statt Regeln. |
| 6 | f | LLMs nutzen zwar komplexe neuronale Netze, schätzen im Kern aber ebenfalls Wahrscheinlichkeiten für die Fortsetzung eines Textes. |
Achte bei Aussage 3 auf das Wort „fest“: Genau das unterscheidet ein regelbasiertes System von einem n-Gramm-Modell, das aus Texten zählt.
Bestimme ohne Computer, was die Funktion
mini_eliza aus dem Abschnitt Ein Mini-ELIZA in
Python auf die folgenden Sätze antwortet. Denke daran: Der Satz
wird zuerst kleingeschrieben, und die Regeln werden von oben nach unten
geprüft. Die erste passende Regel gewinnt.
| Satz | Antwort von mini_eliza |
|---|---|
| Ich fühle mich super | |
| Ich brauche eine Pause | |
| Hast du Hunger? | |
| Mein Handy ist kaputt | |
| Ich brauche Hilfe, kannst du mir helfen? |
Lösung vergleichen
| Satz | Antwort von mini_eliza |
|---|---|
| Ich fühle mich super | Warum fühlst du dich super? |
| Ich brauche eine Pause | Warum brauchst du eine pause? |
| Hast du Hunger? | Interessante Frage - was denkst du selbst darüber? |
| Mein Handy ist kaputt | Erzähl mir mehr davon. |
| Ich brauche Hilfe, kannst du mir helfen? | Warum brauchst du hilfe, kannst du mir helfen?? |
Beim letzten Satz passen zwei Regeln: „ich brauche“ und das Fragezeichen. Die Regel mit „ich brauche“ wird zuerst geprüft und gewinnt. Der Rest des Satzes wird mitsamt Fragezeichen eingesetzt, deshalb stehen am Ende zwei Fragezeichen. Häufiger Fehler: „Pause“ und „Hilfe“ großschreiben. Das Programm hat den ganzen Satz vorher kleingeschrieben.
Entscheide jeweils, ob das Programm regelbasiert arbeitet oder nach dem Prinzip eines n-Gramm-Modells. Begründe kurz.
- Ein Chatbot eines Online-Shops schickt auf jede Nachricht, in der „Rücksendung“ vorkommt, einen Link zum Rücksendeformular.
- Ein Programm hat Tausende Chatnachrichten ausgewertet. Nach „bis“ schlägt es das Wort vor, das dort am häufigsten folgte, zum Beispiel „morgen“.
- Ein Lernspiel prüft, ob deine Antwort das Wort „Photosynthese“ enthält. Wenn ja, zeigt es „Richtig!“.
- Ein Programm hat alle Bände einer Fantasy-Buchreihe ausgezählt. Es setzt angefangene Sätze fort, indem es immer ein Wort wählt, das dort häufig auf die letzten Wörter folgte.
- Ein Sprachassistent im Auto zeigt die nächste Tankstelle an, sobald im gesprochenen Satz das Wort „Tankstelle“ vorkommt.
Meine Antworten:
Lösung vergleichen
- Regelbasiert: feste Regel „Wenn ‚Rücksendung‘ vorkommt, dann schicke den Link“.
- n-Gramm-Modell: Das Programm nutzt, wie häufig Wortpaare in vielen Texten vorkamen.
- Regelbasiert: Es wird nur ein Muster (ein Wort) erkannt. Eine richtige Antwort mit anderen Worten würde nicht erkannt.
- n-Gramm-Modell: Die Bücher sind der Textkorpus, ausgewählt wird nach Häufigkeit.
- Regelbasiert: Schlüsselwort mit fest zugeordneter Reaktion.
Erkennungsmerkmal: gezählt und nach Häufigkeit ausgewählt → n-Gramm-Modell. Feste Wenn-dann-Zuordnung → regelbasiert.
Der Schulkiosk hat einen kleinen regelbasierten Chatbot:
def kiosk_bot(satz):
    satz = satz.lower()
    if "brötchen" in satz:
        return "Brötchen gibt es ab 9:30 Uhr."
    elif "kostet" in satz:
        return "Alle Getränke kosten 1 Euro."
    elif "?" in satz:
        return "Das weiß ich leider nicht."
    else:
return "Hallo! Frag mich etwas zum Kiosk."- Bestimme ohne Computer die Antworten auf die Sätze in der Tabelle. Trage ein, ob die Antwort zur Frage passt (ja/nein).
- Erkläre bei jeder unpassenden Antwort, warum das Programm sie gibt.
| Satz | Antwort | passt? |
|---|---|---|
| Wann gibt es Brötchen? | ||
| Was kostet ein Brötchen? | ||
| Wie teuer ist ein Kakao? | ||
| Was kostet ein Wasser? | ||
| Ich hätte gern einen Kakao. |
Meine Erklärungen:
Lösung vergleichen
print(kiosk_bot("Wann gibt es Brötchen?"))
print(kiosk_bot("Was kostet ein Brötchen?"))
print(kiosk_bot("Wie teuer ist ein Kakao?"))
print(kiosk_bot("Was kostet ein Wasser?"))
print(kiosk_bot("Ich hätte gern einen Kakao."))
Brötchen gibt es ab 9:30 Uhr.
Brötchen gibt es ab 9:30 Uhr.
Das weiß ich leider nicht.
Alle Getränke kosten 1 Euro.
Hallo! Frag mich etwas zum Kiosk.Passend sind die Antworten auf den ersten und den vierten Satz. Unpassend sind:
- „Was kostet ein Brötchen?“: Der Satz enthält „brötchen“ und „kostet“. Die Brötchen-Regel steht zuerst und gewinnt. Gefragt war aber der Preis.
- „Wie teuer ist ein Kakao?“: Gemeint ist dasselbe wie „Was kostet ein Kakao?“, aber das Wort „kostet“ fehlt. Für „teuer“ gibt es keine Regel. Es greift nur die Fragezeichen-Regel.
- „Ich hätte gern einen Kakao.“: Keine Regel passt, auch kein Fragezeichen. Das Programm erkennt nicht, dass jemand etwas bestellen will.
Worauf es ankommt: Das Programm prüft nur, ob bestimmte Zeichenfolgen im Satz stehen. Es versteht weder die Frage noch den Wunsch.
Die Schulbibliothek möchte einen regelbasierten Chatbot.
- Formuliere drei Regeln in der Form „Wenn der Satz … enthält, antworte: …“.
- Nenne zwei Sätze, die eine Schülerin schreiben könnte, bei denen deine Regeln eine unpassende oder gar keine passende Antwort liefern. Erkläre jeweils, warum.
Meine Regeln und Beispiele:
Lösung vergleichen
Musterlösung:
- Wenn der Satz „öffnungszeiten“ enthält, antworte: „Die Bibliothek ist montags bis freitags von 8 bis 14 Uhr geöffnet.“
- Wenn der Satz „ausleihen“ enthält, antworte: „Du kannst bis zu drei Bücher für zwei Wochen ausleihen.“
- Wenn der Satz „verlängern“ enthält, antworte: „Komm mit dem Buch an die Theke, dann verlängern wir es.“
- „Wann habt ihr heute offen?“ – gemeint sind die Öffnungszeiten, aber das Wort „öffnungszeiten“ kommt nicht vor. Keine Regel passt.
- „Ich will kein Buch ausleihen, ich suche nur einen Platz zum Lernen.“ – Die Regel „ausleihen“ greift, obwohl die Schülerin gerade das Gegenteil sagt.
Worauf es ankommt: Deine Regeln reagieren auf feste Wörter. Sätze, die dasselbe mit anderen Wörtern sagen, oder Sätze mit „nicht“ oder „kein“ bringen sie aus dem Tritt. Für die Vielfalt der Sprache bräuchte man sehr viele Regeln.
Schreibe am Computer eine Funktion kiosk_bot_2, die zwei
Schwächen des Kiosk-Bots behebt:
- Fragt jemand nach dem Preis eines Brötchens (der Satz enthält „brötchen“ und „kostet“), antwortet sie: „Ein Brötchen kostet 50 Cent.“
- Das Wort „teuer“ soll genauso behandelt werden wie „kostet“.
Alle anderen Antworten bleiben wie beim Kiosk-Bot. Teste deine Funktion mit den fünf Sätzen aus dem Auftrag Der Kiosk-Bot und zusätzlich mit „Ist ein Brötchen teuer?“.
Überlege genau, in welcher Reihenfolge die Regeln
stehen müssen. Eine Regel, die zwei Bedingungen braucht, muss vor den
Regeln stehen, die nur eine davon prüfen. Bedingungen verknüpfst du mit
and und or. Klammern helfen, den Überblick zu
behalten.
Lösung vergleichen
def kiosk_bot_2(satz):
    satz = satz.lower()
    preisfrage = "kostet" in satz or "teuer" in satz
    if "brötchen" in satz and preisfrage:
        return "Ein Brötchen kostet 50 Cent."
    elif "brötchen" in satz:
        return "Brötchen gibt es ab 9:30 Uhr."
    elif preisfrage:
        return "Alle Getränke kosten 1 Euro."
    elif "?" in satz:
        return "Das weiß ich leider nicht."
    else:
        return "Hallo! Frag mich etwas zum Kiosk."

print(kiosk_bot_2("Wann gibt es Brötchen?"))
print(kiosk_bot_2("Was kostet ein Brötchen?"))
print(kiosk_bot_2("Wie teuer ist ein Kakao?"))
print(kiosk_bot_2("Was kostet ein Wasser?"))
print(kiosk_bot_2("Ich hätte gern einen Kakao."))
print(kiosk_bot_2("Ist ein Brötchen teuer?"))
Brötchen gibt es ab 9:30 Uhr.
Ein Brötchen kostet 50 Cent.
Alle Getränke kosten 1 Euro.
Alle Getränke kosten 1 Euro.
Hallo! Frag mich etwas zum Kiosk.
Ein Brötchen kostet 50 Cent.- Zeile 3: Die Variable
preisfragespeichert, ob „kostet“ oder „teuer“ im Satz steht (TrueoderFalse). So musst du dieor-Bedingung nur einmal schreiben. - Zeilen 4–5: Die neue Regel mit zwei Bedingungen steht ganz oben. Stünde sie unter der Brötchen-Regel, würde sie nie erreicht.
- Zeilen 8–9: Die Preisregel reagiert jetzt auch auf „teuer“.
Auch ohne die Variable preisfrage ist die Lösung
richtig, wenn du
"brötchen" in satz and ("kostet" in satz or "teuer" in satz)
schreibst. Ohne die Klammern würde Python erst and
auswerten, dann wäre die Bedingung schon bei „Wie teuer ist ein Kakao?“
wahr. Der Wunsch „Ich hätte gern einen Kakao.“ wird weiterhin nicht
erkannt. Dafür bräuchte man noch eine Regel – und so geht es immer
weiter.
4.1.7Das Wichtigste in Kürze
- Ein Sprachmodell erfasst sprachliche Strukturen bzw. Wahrscheinlichkeiten, um Texte zu analysieren oder zu erzeugen.
- Regelbasierte Systeme wie ELIZA (1966) reagieren nach fest programmierten Wenn-dann-Regeln und erkennen nur Muster in der Eingabe.
- Regelbasierte Systeme scheitern an der Vielfalt der Sprache: Für jede Formulierung bräuchte man eine eigene Regel.
- n-Gramm-Modelle zählen in großen Textsammlungen, wie oft Wortfolgen (n-Gramme) vorkommen, und sagen damit das nächste Wort voraus (next word prediction).
- Moderne LLMs nutzen neuronale Netze, schätzen aber ebenfalls Wahrscheinlichkeiten für die Fortsetzung eines Textes.
- Keines dieser Systeme versteht die Bedeutung dessen, was es verarbeitet.
4.2n-Gramme zählen: ein Sprachmodell von Hand trainieren DS31
Diesen Abschnitt als PDF (S. 16–30)
Das Jupyter-Notebook aus dem Unterricht: DS31_nGramm_von_Hand.ipynb. Herunterladen und in VS Code oder Jupyter öffnen.
Ein n-Gramm-Modell lernt Sprache, indem es zählt. Das klingt einfach – und das ist es auch. In diesem Abschnitt machst du genau das, was der Computer beim Training eines n-Gramm-Modells tut: Du nimmst einen kurzen Text, zerlegst ihn in Wortpaare, zählst sie und berechnest daraus, mit welcher Wahrscheinlichkeit auf ein Wort ein bestimmtes anderes Wort folgt. Am Ende hast du ein kleines Sprachmodell auf Papier. Zur Kontrolle lässt du Python nachzählen.
Nach diesem Abschnitt kannst du
- erklären, was ein n-Gramm ist, und Unigramme, Bigramme und Trigramme unterscheiden,
- die Begriffe Textkorpus und Textkörperanalyse erläutern,
- in einem kurzen Text alle Bigramme von Hand ermitteln und zählen,
- aus den Häufigkeiten die Wahrscheinlichkeiten für Folgewörter berechnen und in einer Tabelle festhalten,
- eine Handauszählung mit einem Python-Programm überprüfen.
4.2.1Was ist ein n-Gramm?
Nimm den Satz „der hund bellt laut“. Du kannst ihn auf verschiedene Arten in Stücke schneiden:
- in einzelne Wörter: „der“, „hund“, „bellt“, „laut“,
- in Wortpaare: „der hund“, „hund bellt“, „bellt laut“,
- in Dreiergruppen: „der hund bellt“, „hund bellt laut“.
Jedes dieser Stücke ist ein n-Gramm. Das n gibt an, wie viele Wörter direkt hintereinander zu einem Stück gehören. Die Stücke überlappen sich: Jedes neue Stück beginnt ein Wort weiter rechts als das vorige.
| Name | n | Stücke aus „der hund bellt laut“ | Anzahl |
|---|---|---|---|
| Unigramm | 1 | der · hund · bellt · laut | 4 |
| Bigramm | 2 | der hund · hund bellt · bellt laut | 3 |
| Trigramm | 3 | der hund bellt · hund bellt laut | 2 |
Mit jedem Wort mehr pro Stück gibt es ein Stück weniger. Allgemein gilt: Ein Text mit Wörtern hat n-Gramme. Für Bigramme () sind das .
- Ein n-Gramm ist eine Folge von
aufeinanderfolgenden Wörtern (oder Zeichen) aus einem Text.
- Unigramm (): einzelne Wörter
- Bigramm (): Wortpaare
- Trigramm (): Wortdreiergruppen
Statt Wörtern kann man auch Zeichen zu n-Grammen zusammenfassen. Die Zeichen-Bigramme von „hund“ sind „hu“, „un“ und „nd“. In diesem Kapitel geht es aber immer um Wörter.
4.2.2Textkorpus und Textkörperanalyse
Ein n-Gramm-Modell braucht Text, aus dem es lernen kann. Diese Textsammlung heißt Textkorpus oder kurz Korpus (lateinisch corpus = Körper; deshalb sagt man auch Textkörper). Bei echten Sprachmodellen besteht der Korpus aus riesigen Mengen an Büchern, Zeitungsartikeln und Internetseiten. Bei uns sind es zunächst nur ein oder zwei Sätze. Das Prinzip ist dasselbe.
Ein Textkorpus (auch Textkörper) ist eine Sammlung von Texten, die als Trainingstext für ein Sprachmodell dient.
Bei der Textkörperanalyse wird ermittelt, wie oft jedes n-Gramm in einem Textkorpus vorkommt. Aus diesen Häufigkeiten werden anschließend Wahrscheinlichkeiten berechnet.
Bei der Textkörperanalyse zählt man, wie oft jedes n-Gramm in einem Textkorpus (Trainingstext) vorkommt.
Damit das Zählen eindeutig ist, schreiben wir in diesem Kapitel alle Wörter klein und lassen Satzzeichen weg. Sonst wären „Der“ und „der“ für den Computer zwei verschiedene Wörter.
4.2.3Bigramme von Hand zählen
Wir untersuchen diesen Textkorpus:
der hund läuft der hund bellt der hund schläft
Der Text hat 9 Wörter, also gibt es Bigramme. Du findest sie, indem du ein „Fenster“ aus zwei Wörtern über den Text schiebst – immer um ein Wort weiter:
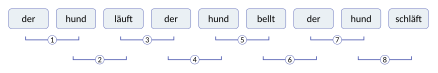
Als Liste geschrieben sind das die acht Bigramme: der hund · hund läuft · läuft der · der hund · hund bellt · bellt der · der hund · hund schläft.
Jetzt wird gezählt. Am einfachsten geht das mit einer Strichliste: Du gehst die Liste von links nach rechts durch. Kommt ein Bigramm zum ersten Mal vor, bekommt es eine neue Zeile. Kommt es noch einmal vor, machst du einen weiteren Strich.
| Bigramm | Strichliste | Anzahl |
|---|---|---|
| der hund | III | 3 |
| hund läuft | I | 1 |
| läuft der | I | 1 |
| hund bellt | I | 1 |
| bellt der | I | 1 |
| hund schläft | I | 1 |
| Summe | 8 |
Die Summe muss genau die Anzahl der Bigramme ergeben, hier 8. Das ist eine gute Kontrolle, ob du keines vergessen hast.
Das Ergebnis: Auf das Wort „der“ folgt in diesem Text dreimal „hund“ – und nie etwas anderes. Das ist mit Abstand das häufigste Bigramm mit „der“ als erstem Wort. Auf „hund“ folgen dagegen drei verschiedene Wörter, jedes genau einmal.
Beim Zählen von Hand passieren leicht Fehler. Nummeriere die Wörter des Textes vorher durch und streiche jedes Bigramm in der Liste ab, sobald du es gezählt hast.
Gegeben ist der Textkorpus:
die katze schläft die katze spielt die katze frisst die katze schläft
- Ermittle von Hand alle Bigramme und zähle, wie oft jedes vorkommt. Lege dazu eine Tabelle mit Strichliste an.
- Welches Wort folgt im Korpus am häufigsten direkt auf „die“?
- Welches Wort folgt am häufigsten auf „katze“?
Meine Auszählung:
Lösung vergleichen
Der Text hat 12 Wörter, also gibt es 11 Bigramme:
| Bigramm | Strichliste | Anzahl |
|---|---|---|
| die katze | IIII | 4 |
| katze schläft | II | 2 |
| schläft die | I | 1 |
| katze spielt | I | 1 |
| spielt die | I | 1 |
| katze frisst | I | 1 |
| frisst die | I | 1 |
| Summe | 11 |
Zu 2: Auf „die“ folgt immer „katze“ – alle 4 Bigramme, die mit „die“ beginnen, lauten „die katze“.
Zu 3: Auf „katze“ folgt am häufigsten „schläft“ (zweimal), „spielt“ und „frisst“ folgen je einmal. Weil vor „katze“ in diesem Text immer „die“ steht, folgt also auch auf „die katze“ am häufigsten „schläft“. Das ist schon eine Frage nach Trigrammen – Dreiergruppen wie „die katze schläft“, die zweimal vorkommt.
Häufiger Fehler: „schläft“ steht zweimal im Text, aber das zweite „schläft“ ist das letzte Wort. Danach kommt nichts mehr, also gibt es „schläft die“ nur einmal.
4.2.4Von der Häufigkeit zur Wahrscheinlichkeit
Häufigkeiten allein reichen noch nicht. Ein Sprachmodell will wissen: Wenn gerade das Wort „der“ dasteht – wie wahrscheinlich ist es dann, dass als nächstes „hund“ kommt? Dafür vergleicht man, wie oft „der hund“ vorkommt, mit der Anzahl aller Bigramme, die mit „der“ beginnen.
Wir rechnen das an einem neuen Korpus Schritt für Schritt durch. Er ist etwas abwechslungsreicher, damit interessantere Zahlen entstehen:
der hund bellt der hund läuft der ball rollt der hund bellt
Schritt 1: Wörter und Bigramme ermitteln. Der Text hat 12 Wörter, also Bigramme:
der hund · hund bellt · bellt der · der hund · hund läuft · läuft der · der ball · ball rollt · rollt der · der hund · hund bellt
Schritt 2: Bigramme zählen und nach dem ersten Wort ordnen. Alle Bigramme mit demselben ersten Wort stehen untereinander. Das erste Wort nennen wir Vorgängerwort, das zweite Folgewort.
| Vorgängerwort | Folgewort | Anzahl |
|---|---|---|
| der | hund | 3 |
| der | ball | 1 |
| hund | bellt | 2 |
| hund | läuft | 1 |
| bellt | der | 1 |
| läuft | der | 1 |
| ball | rollt | 1 |
| rollt | der | 1 |
Kontrolle: . ✓
Schritt 3: Wie oft steht jedes Vorgängerwort vorne in einem Bigramm? Dazu addierst du die Anzahlen in seinen Zeilen: „der“ , „hund“ , „bellt“ 1, „läuft“ 1, „ball“ 1, „rollt“ 1.
Schritt 4: Wahrscheinlichkeit berechnen. Teile die Anzahl des Bigramms durch die Zahl aus Schritt 3. Für „der“, gefolgt von „hund“: Für „hund“, gefolgt von „bellt“:
Das Zeichen steht für probability, englisch für Wahrscheinlichkeit. liest du: „die Wahrscheinlichkeit, dass auf ‚der‘ das Wort ‚hund‘ folgt“.
Rechnest du das für alle Zeilen aus, erhältst du die vollständige Wahrscheinlichkeitstabelle des Modells:
| Vorgängerwort | Folgewort | Anzahl | Rechnung | Wahrscheinlichkeit |
|---|---|---|---|---|
| der | hund | 3 | 0,75 = 75 % | |
| der | ball | 1 | 0,25 = 25 % | |
| hund | bellt | 2 | ≈ 0,67 = 67 % | |
| hund | läuft | 1 | ≈ 0,33 = 33 % | |
| bellt | der | 1 | 1 = 100 % | |
| läuft | der | 1 | 1 = 100 % | |
| ball | rollt | 1 | 1 = 100 % | |
| rollt | der | 1 | 1 = 100 % |
Für jedes Vorgängerwort ergeben die Wahrscheinlichkeiten zusammen genau 1, also 100 %: bei „der“ , bei „hund“ . Das ist logisch, denn irgendein Folgewort kommt nach „der“ ja immer. Diese Summe ist deine Kontrolle.
Die Wahrscheinlichkeit, dass auf ein Wort A das Wort B folgt, berechnet man so: Für jedes Vorgängerwort ergeben die Wahrscheinlichkeiten aller Folgewörter zusammen 1 (also 100 %).
Im Nenner steht nicht die Gesamtzahl aller Bigramme im Text, sondern nur die Anzahl der Bigramme, die mit dem Vorgängerwort beginnen. wäre für „der hund“ also falsch.
Vorsicht auch beim letzten Wort: „bellt“ steht zweimal im Text. Das zweite „bellt“ ist aber das letzte Wort, danach folgt nichts mehr. Deshalb beginnt nur ein Bigramm mit „bellt“, und es gilt , nicht . Zähle im Nenner also nur Vorkommen, auf die noch ein Wort folgt.
Man kann ein solches Modell auch als Wortgraph zeichnen: Jedes Wort ist ein Kästchen, und ein Pfeil führt zu jedem möglichen Folgewort. Am Pfeil steht die Wahrscheinlichkeit.
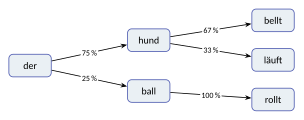
Aus den Häufigkeiten lässt sich die Wahrscheinlichkeit ableiten, mit der auf ein bestimmtes Wort (bzw. eine Wortfolge) ein bestimmtes Folgewort folgt. Das ist die Grundlage für die spätere Textgenerierung.
So beschreibst du deine Ergebnisse in Fachsprache:
- „Nach der kommt meistens hund.“ → „Im Korpus folgt auf ‚der‘ in drei von vier Fällen ‚hund‘.“
- „hund bellt ist 67 %.“ → „Die Wahrscheinlichkeit, dass auf ‚hund‘ das Wort ‚bellt‘ folgt, beträgt .“
Verwende deine Häufigkeiten aus dem Auftrag Von Hand zählen (Korpus „die katze schläft die katze spielt …“).
- Berechne die Wahrscheinlichkeit für jedes Wort, das auf „die“ folgt: Anzahl des jeweiligen Bigramms geteilt durch die Gesamtanzahl aller Bigramme, die mit „die“ beginnen.
- Berechne ebenso die Wahrscheinlichkeiten für alle Wörter, die auf „katze“ folgen. Gib sie als Bruch, als Dezimalzahl und in Prozent an.
Meine Rechnung:
Lösung vergleichen
- Mit „die“ beginnen 4 Bigramme, alle lauten „die katze“: . In diesem Text folgt auf „die“ also immer „katze“.
- Mit „katze“ beginnen Bigramme:
| Vorgängerwort | Folgewort | Anzahl | Wahrscheinlichkeit |
|---|---|---|---|
| katze | schläft | 2 | |
| katze | spielt | 1 | |
| katze | frisst | 1 |
Kontrolle: . ✓
Tim soll für den Korpus „ich mag tee ich mag kaffee ich trinke tee“ die Wahrscheinlichkeitstabelle aufstellen. Er schreibt:
| Vorgängerwort | Folgewort | Wahrscheinlichkeit |
|---|---|---|
| ich | mag | |
| ich | trinke | |
| tee | ich |
- Beschreibe Tims zwei Fehler.
- Stelle die vollständige und richtige Wahrscheinlichkeitstabelle für diesen Korpus auf.
Fehler und richtige Tabelle:
Lösung vergleichen
- Fehler 1: Tim teilt bei „ich“ durch 8, die Anzahl aller Bigramme. Richtig ist die Anzahl der Bigramme, die mit „ich“ beginnen: 3. Fehler 2: „tee“ kommt zwar zweimal vor, das zweite „tee“ ist aber das letzte Wort. Nur ein Bigramm beginnt mit „tee“, also ist . (Außerdem fehlen Zeilen.)
- Der Korpus hat 9 Wörter und 8 Bigramme: ich mag · mag tee · tee ich · ich mag · mag kaffee · kaffee ich · ich trinke · trinke tee.
| Vorgängerwort | Folgewort | Anzahl | Wahrscheinlichkeit |
|---|---|---|---|
| ich | mag | 2 | |
| ich | trinke | 1 | |
| mag | tee | 1 | |
| mag | kaffee | 1 | |
| tee | ich | 1 | |
| kaffee | ich | 1 | |
| trinke | tee | 1 |
Kontrolle: Die Anzahlen ergeben zusammen 8, und für jedes Vorgängerwort ergeben die Wahrscheinlichkeiten zusammen 1.
4.2.5Trigramme: mehr Wörter als Kontext
Bei Bigrammen hängt das Folgewort nur vom einen Wort davor ab. Bei Trigrammen schaut man auf die zwei Wörter davor. Diese Wörter, auf die das Modell beim Vorhersagen schaut, heißen Kontext.
Im Korpus „der hund bellt der hund läuft der ball rollt der hund bellt“ gibt es Trigramme. Drei davon beginnen mit dem Kontext „der hund“:
| Kontext | Folgewort | Anzahl | Wahrscheinlichkeit |
|---|---|---|---|
| der hund | bellt | 2 | |
| der hund | läuft | 1 |
Gerechnet wird genau wie bei Bigrammen: Anzahl des Trigramms geteilt durch die Anzahl aller Trigramme mit demselben Kontext. In diesem kleinen Text ändert sich dadurch noch nichts. In langen Texten macht der längere Kontext aber einen großen Unterschied: Nach „die“ kann fast alles kommen, nach „die katze“ schon viel weniger. Wie sich das auf erzeugte Texte auswirkt, untersuchst du im Abschnitt über Textgenerierung.
4.2.6Kontrolle mit Python
Bei kurzen Texten geht das Zählen von Hand. Bei langen Texten ist es mühsam und fehleranfällig. Hier hilft ein Programm. Zuerst muss der Text in einzelne Wörter zerlegt werden.
Mit text.split() zerlegst du eine Zeichenkette an den
Leerzeichen in ihre Wörter. Das Ergebnis ist eine Liste
von Zeichenketten. Mehrere Leerzeichen und Zeilenumbrüche hintereinander
zählen dabei wie ein einziges Leerzeichen.
satz = "der hund bellt laut"
woerter = satz.split()
print(woerter)
print(len(woerter))
['der', 'hund', 'bellt', 'laut']
4Mit dieser Liste kannst du alle Bigramme ausgeben. Das Bigramm Nummer
i besteht aus dem Wort an der Stelle i und dem
Wort an der Stelle i + 1:
korpus = "der hund läuft der hund bellt der hund schläft"
woerter = korpus.split()
for i in range(len(woerter) - 1):
    print(woerter[i], woerter[i + 1])
der hund
hund läuft
läuft der
der hund
hund bellt
bellt der
der hund
hund schläft- Zeile 2:
woerterist jetzt die Liste['der', 'hund', 'läuft', …]mit 9 Elementen. Die Indizes laufen von 0 bis 8. - Zeile 3: Die Schleife läuft nur bis
len(woerter) - 1, also fürivon 0 bis 7. Das sind genau 8 Durchläufe – so viele, wie es Bigramme gibt. - Zeile 4: Ausgegeben werden das Wort an Stelle
iund sein Nachfolger an Stellei + 1. Das ist das „Fenster“ aus der Abbildung oben.
Schreibst du in der Schleife nur range(len(woerter)),
läuft i bis zum letzten Index. Im letzten Durchlauf will
das Programm dann das Wort nach dem letzten Wort lesen.
Das gibt es nicht. Hier ein kurzes Beispiel mit drei Wörtern (Indizes 0
bis 2): Im dritten Durchlauf ist i = 2, und
woerter[3] existiert nicht.
woerter = "der hund bellt".split()
for i in range(len(woerter)):
    print(woerter[i], woerter[i + 1])
der hund
hund belltIndexError: list index out of rangeDas letzte Wort hat keinen Nachfolger. Deshalb gibt es ein Bigramm weniger als Wörter.
Jetzt soll das Programm auch zählen. Dazu speichern wir jedes Bigramm
als Zeichenkette aus zwei Wörtern, zum Beispiel
"die katze", in einer Liste. Dann gehen wir so vor wie bei
der Strichliste: Zuerst sammeln wir alle verschiedenen
Bigramme, dann zählen wir für jedes, wie oft es in der Liste
vorkommt.
def zaehle(liste, gesucht):
    anzahl = 0
    for element in liste:
        if element == gesucht:
            anzahl += 1
    return anzahl

korpus = "die katze schläft die katze spielt "
korpus = korpus + "die katze frisst die katze schläft"
woerter = korpus.split()

bigramme = []
for i in range(len(woerter) - 1):
    bigramme.append(woerter[i] + " " + woerter[i + 1])

verschiedene = []
for bigramm in bigramme:
    if bigramm not in verschiedene:
        verschiedene.append(bigramm)

for bigramm in verschiedene:
    print(bigramm, ":", zaehle(bigramme, bigramm))
die katze : 4
katze schläft : 2
schläft die : 1
katze spielt : 1
spielt die : 1
katze frisst : 1
frisst die : 1- Zeilen 1–6: Eine solche Zählfunktion kennst du von
den Listenalgorithmen.
zaehlezählt, wie oftgesuchtin der Liste vorkommt. - Zeilen 8–10: Der Korpus ist für eine Zeile zu lang.
Deshalb wird er in zwei Teilen gebildet und mit
+zusammengesetzt. Dann wird er in Wörter zerlegt. - Zeilen 12–14: Für jede Position
iwird das Bigramm als Zeichenkette gebildet, z. B."die" + " " + "katze"ergibt"die katze", und an die Listebigrammeangehängt. Sie enthält danach alle 11 Bigramme, auch die doppelten. - Zeilen 16–19: In
verschiedenekommt jedes Bigramm nur einmal, nämlich beim ersten Auftreten. Das entspricht dem Anlegen einer neuen Zeile in der Strichliste. - Zeilen 21–22: Für jedes verschiedene Bigramm wird
gezählt, wie oft es in
bigrammesteht.
Vergleiche die Ausgabe mit deiner Lösung zum Auftrag Von Hand zählen. Die Zahlen müssen übereinstimmen.
Setze in den Zeilen 8 und 9 den Korpus „der hund bellt der hund läuft
der ball rollt der hund bellt“ ein und vergleiche mit der Tabelle aus
dem Beispiel Wahrscheinlichkeiten Schritt für Schritt. Ergänze
dann eine Zeile, die die Anzahl aller Bigramme mit
len(bigramme) ausgibt.
4.2.7Übungen
Erweitere das Programm aus dem Abschnitt Kontrolle mit Python so, dass es Trigramme (Dreiergruppen) statt Bigramme zählt. Verwende deinen eigenen, etwas längeren Beispielsatz.
Lösung vergleichen
def zaehle(liste, gesucht):
    anzahl = 0
    for element in liste:
        if element == gesucht:
            anzahl += 1
    return anzahl

korpus = "wenn es regnet lese ich und wenn es regnet schlafe ich"
woerter = korpus.split()

trigramme = []
for i in range(len(woerter) - 2):
    trigramme.append(woerter[i] + " " + woerter[i + 1] + " "
                     + woerter[i + 2])

verschiedene = []
for trigramm in trigramme:
    if trigramm not in verschiedene:
        verschiedene.append(trigramm)

for trigramm in verschiedene:
    print(trigramm, ":", zaehle(trigramme, trigramm))
wenn es regnet : 2
es regnet lese : 1
regnet lese ich : 1
lese ich und : 1
ich und wenn : 1
und wenn es : 1
es regnet schlafe : 1
regnet schlafe ich : 1Zwei Stellen ändern sich: Die Schleife läuft nur bis
len(woerter) - 2, weil das letzte Trigramm beim
drittletzten Wort beginnt. Und jedes Trigramm wird aus drei Wörtern
zusammengesetzt. Der Text hat 11 Wörter, also
Trigramme. Ausgegeben werden 8 Zeilen, weil „wenn es regnet“ doppelt
vorkommt.
4.2.8Weitere Übungen
Hier kannst du das Gelernte weiter üben. Die Punkte im Titel zeigen, wie schwer eine Aufgabe ist: ●○○ leicht, ●●○ mittel, ●●● knifflig. Fang mit den leichten an.
- Bestimme für den Satz „wir fahren morgen nach saarbrücken“ alle Unigramme, Bigramme und Trigramme und gib jeweils die Anzahl an.
- n-Gramme kann man auch aus Zeichen bilden. Bestimme die Zeichen-Bigramme des Wortes „kino“.
| n-Gramme | Anzahl | |
|---|---|---|
| Unigramme | ||
| Bigramme | ||
| Trigramme | ||
| Zeichen-Bigramme von „kino“ |
Lösung vergleichen
| n-Gramme | Anzahl | |
|---|---|---|
| Unigramme | wir · fahren · morgen · nach · saarbrücken | 5 |
| Bigramme | wir fahren · fahren morgen · morgen nach · nach saarbrücken | 4 |
| Trigramme | wir fahren morgen · fahren morgen nach · morgen nach saarbrücken | 3 |
| Zeichen-Bigramme von „kino“ | ki · in · no | 3 |
Jedes neue n-Gramm beginnt ein Wort (bzw. ein Zeichen) weiter rechts. Deshalb überlappen sich die Stücke, und mit jedem Wort mehr pro Stück gibt es eines weniger.
Bestimme für jeden Text die Anzahl der Wörter, die Anzahl der Bigramme und die Anzahl der verschiedenen Bigramme.
| Text | Wörter | Bigramme | verschiedene Bigramme |
|---|---|---|---|
| ich bin ich | |||
| la la la la | |||
| heute ist heute und morgen ist morgen | |||
| du und ich und du und ich |
Lösung vergleichen
| Text | Wörter | Bigramme | verschiedene Bigramme |
|---|---|---|---|
| ich bin ich | 3 | 2 | 2 |
| la la la la | 4 | 3 | 1 |
| heute ist heute und morgen ist morgen | 7 | 6 | 6 |
| du und ich und du und ich | 7 | 6 | 4 |
Es gibt immer ein Bigramm weniger als Wörter, weil das letzte Wort keinen Nachfolger hat. Bei „la la la la“ lauten alle drei Bigramme „la la“. Bei „du und ich und du und ich“ kommen „du und“ und „und ich“ je zweimal vor. Bei „heute ist heute und morgen ist morgen“ kommen die Wörter mehrfach vor, aber kein Wortpaar wiederholt sich: „ist heute“ und „ist morgen“ sind verschiedene Bigramme.
Gegeben ist der Textkorpus:
wir spielen fußball wir spielen basketball wir schauen fußball
- Ermittle alle Bigramme und zähle sie mit einer Strichliste.
- Welches Wort folgt am häufigsten auf „wir“?
| Bigramm | Strichliste | Anzahl |
|---|---|---|
| Summe |
Lösung vergleichen
Der Text hat 9 Wörter, also gibt es 8 Bigramme:
| Bigramm | Strichliste | Anzahl |
|---|---|---|
| wir spielen | II | 2 |
| spielen fußball | I | 1 |
| fußball wir | I | 1 |
| spielen basketball | I | 1 |
| basketball wir | I | 1 |
| wir schauen | I | 1 |
| schauen fußball | I | 1 |
| Summe | 8 |
Zu 2: Auf „wir“ folgt am häufigsten „spielen“ (zweimal), „schauen“ nur einmal.
„fußball“ kommt zweimal vor, aber das zweite „fußball“ ist das letzte Wort. Deshalb gibt es „fußball wir“ nur einmal.
In einem großen Korpus wurde gezählt, welche Wörter auf „gehe“ folgen: 5-mal „ins“, 3-mal „nach“ und 2-mal „zum“. Andere Folgewörter gibt es nicht.
- Berechne die Wahrscheinlichkeit für jedes Folgewort als Bruch, als Dezimalzahl und in Prozent.
- Kontrolliere mit der Summe.
- Welches Folgewort ist am wahrscheinlichsten?
| Kontext | Folgewort | Anzahl | Bruch | Dezimalzahl | Prozent |
|---|---|---|---|---|---|
| gehe | ins | 5 | |||
| gehe | nach | 3 | |||
| gehe | zum | 2 |
Lösung vergleichen
Mit „gehe“ beginnen Bigramme. Das ist der Nenner.
| Kontext | Folgewort | Anzahl | Bruch | Dezimalzahl | Prozent |
|---|---|---|---|---|---|
| gehe | ins | 5 | 0,5 | 50 % | |
| gehe | nach | 3 | 0,3 | 30 % | |
| gehe | zum | 2 | 0,2 | 20 % |
Kontrolle: . ✓ Am wahrscheinlichsten ist „ins“.
Gegeben ist der Textkorpus:
ich höre musik ich höre podcasts ich lese comics ich höre musik
- Ermittle alle Bigramme und ihre Häufigkeiten.
- Stelle die vollständige Wahrscheinlichkeitstabelle auf (Kontext, Folgewort, Anzahl, Wahrscheinlichkeit als Bruch und in Prozent).
- Kontrolliere: Ergeben für jeden Kontext die Wahrscheinlichkeiten zusammen 1?
Meine Auszählung und meine Tabelle:
Lösung vergleichen
Der Text hat 12 Wörter, also 11 Bigramme: ich höre · höre musik · musik ich · ich höre · höre podcasts · podcasts ich · ich lese · lese comics · comics ich · ich höre · höre musik.
| Kontext | Folgewort | Anzahl | Wahrscheinlichkeit |
|---|---|---|---|
| ich | höre | 3 | |
| ich | lese | 1 | |
| höre | musik | 2 | |
| höre | podcasts | 1 | |
| musik | ich | 1 | |
| podcasts | ich | 1 | |
| lese | comics | 1 | |
| comics | ich | 1 |
Kontrolle: Die Anzahlen ergeben zusammen , und für jeden Kontext ergeben die Wahrscheinlichkeiten 1.
Häufiger Fehler: Bei „musik“ durch 2 teilen, weil „musik“ zweimal im Text steht. Das zweite „musik“ ist aber das letzte Wort. Nur ein Bigramm beginnt mit „musik“.
Gegeben ist der Textkorpus:
er spielt gitarre sie spielt geige er spielt gitarre sie spielt klavier
- Bestimme mit Bigrammen die Wahrscheinlichkeiten aller Folgewörter von „spielt“.
- Bestimme alle Trigramme, die mit dem Kontext „er spielt“ beginnen, und alle, die mit dem Kontext „sie spielt“ beginnen. Berechne die Wahrscheinlichkeiten der Folgewörter.
- Vergleiche: Was ändert sich, wenn das Modell zwei Wörter als Kontext benutzt statt einem?
Meine Rechnungen und mein Vergleich:
Lösung vergleichen
- Mit „spielt“ beginnen 4 Bigramme: spielt gitarre (2), spielt geige (1), spielt klavier (1).
| Kontext | Folgewort | Anzahl | Wahrscheinlichkeit |
|---|---|---|---|
| spielt | gitarre | 2 | |
| spielt | geige | 1 | |
| spielt | klavier | 1 |
- Der Korpus hat 12 Wörter, also 10 Trigramme. Davon beginnen zwei mit „er spielt“ und zwei mit „sie spielt“:
| Kontext | Folgewort | Anzahl | Wahrscheinlichkeit |
|---|---|---|---|
| er spielt | gitarre | 2 | |
| sie spielt | geige | 1 | |
| sie spielt | klavier | 1 |
- Mit einem Wort als Kontext weiß das Modell nicht, wer spielt. Auf „spielt“ kann jedes der drei Instrumente folgen. Mit zwei Wörtern als Kontext unterscheidet das Modell „er spielt“ und „sie spielt“: Nach „er spielt“ folgt im Korpus immer „gitarre“, nach „sie spielt“ nie. Der längere Kontext macht die Vorhersage also genauer.
Bestimme ohne Computer, was das Programm ausgibt. Wie viele Zeilen sind es?
korpus = "ich mag eis ich mag pizza"
woerter = korpus.split()
for i in range(len(woerter) - 2):
    print(woerter[i], woerter[i + 1], woerter[i + 2])
Ausgabe:
Lösung vergleichen
for i in range(len(woerter) - 2):
    print(woerter[i], woerter[i + 1], woerter[i + 2])
ich mag eis
mag eis ich
eis ich mag
ich mag pizzaEs sind 4 Zeilen. Die Liste woerter hat 6 Elemente
(Indizes 0 bis 5). range(len(woerter) - 2) ist also
range(4), und i läuft von 0 bis 3. In jedem
Durchlauf werden drei aufeinanderfolgende Wörter ausgegeben – die
Trigramme des Textes. Das letzte Trigramm beginnt beim Index 3, beim
drittletzten Wort. Würde i bis 4 laufen, gäbe es
woerter[6] nicht, und Python meldet einen
IndexError.
- Schreibe einen möglichst kurzen Korpus, für den gilt:
- Auf „ich“ folgt mit der Wahrscheinlichkeit „lache“ und mit „weine“.
- Auf „lache“ folgt immer „ich“.
- Kontrolliere deinen Korpus, indem du die Wahrscheinlichkeitstabelle aufstellst.
- Begründe, warum ein solcher Korpus aus mindestens 6 Wörtern bestehen muss.
Mein Korpus, meine Kontrolle und meine Begründung:
Lösung vergleichen
- Ein möglicher Korpus: ich lache ich weine ich lache
- Die 5 Bigramme sind: ich lache · lache ich · ich weine · weine ich · ich lache.
| Kontext | Folgewort | Anzahl | Wahrscheinlichkeit |
|---|---|---|---|
| ich | lache | 2 | |
| ich | weine | 1 | |
| lache | ich | 1 | |
| weine | ich | 1 |
Das zweite „lache“ ist das letzte Wort. Es hat keinen Nachfolger und zählt deshalb nicht mit. Auf „lache“ folgt also in jedem Bigramm „ich“. 3. Die Wahrscheinlichkeiten und brauchen mindestens 3 Bigramme, die mit „ich“ beginnen. Also muss „ich“ mindestens dreimal vorkommen, und jedes Mal muss ein Folgewort dahinterstehen („lache“ oder „weine“, nie „ich“ selbst). Das sind mindestens Wörter.
Auch andere Korpora sind richtig, z. B. „ich weine ich lache ich lache“ oder ein längerer wie „ich lache ich lache ich weine ich lache ich weine ich lache“ (dort 4 von 6 und 2 von 6, also wieder und ). Prüfe bei deinem Korpus immer auch das letzte Wort.
4.2.9Das Wichtigste in Kürze
- Ein n-Gramm ist eine Folge von aufeinanderfolgenden Wörtern: Unigramm (1), Bigramm (2), Trigramm (3). Ein Text mit Wörtern hat Bigramme.
- Der Textkorpus ist der Trainingstext. Bei der Textkörperanalyse zählt man, wie oft jedes n-Gramm darin vorkommt.
- Bigramme findet man mit einem „Fenster“ aus zwei Wörtern, das Wort für Wort weiterrückt. Gezählt wird mit einer Strichliste.
- = Anzahl von „A B“ geteilt durch die Anzahl aller Bigramme, die mit A beginnen.
- Für jedes Vorgängerwort ergeben die Wahrscheinlichkeiten zusammen 1 (100 %).
- Bei Trigrammen besteht der Kontext aus zwei Wörtern.
- In Python zerlegt
text.split()einen Text in eine Liste von Wörtern. Damit kann man alle n-Gramme bilden und zählen.
4.3Textanalyse mit dem Computer DS32
Diesen Abschnitt als PDF (S. 31–41)
Das Jupyter-Notebook aus dem Unterricht: DS32_Rechnergestuetzte_Textanalyse.ipynb. Herunterladen und in VS Code oder Jupyter öffnen.
Zwei Sätze von Hand auszuzählen, geht gut. Aber ein echtes Sprachmodell lernt aus Millionen von Sätzen. Dort würdest du mit der Strichliste nie fertig. In diesem Abschnitt überlässt du das Zählen dem Computer: Du schreibst ein Python-Programm, das zu jedem Wort eines Textes die möglichen Folgewörter mit ihrer Häufigkeit ermittelt. Außerdem lernst du SoekiaGPT kennen, ein Lernprogramm im Browser, das dieselbe Analyse an größeren Textsammlungen vorführt.
Nach diesem Abschnitt kannst du
- begründen, warum größere Textkorpora rechnergestützt analysiert werden,
- beschreiben, wie n-Gramm-Häufigkeiten in einer Tabelle verwaltet werden,
- ein Python-Programm nutzen und erweitern, das zu einem Wort alle Folgewörter mit Häufigkeit und Wahrscheinlichkeit ermittelt,
- einen eigenen Textkorpus mit diesem Programm analysieren,
- mit SoekiaGPT n-Gramme in einer Textsammlung untersuchen.
4.3.1Warum der Computer zählen muss
Im letzten Abschnitt hattest du Texte mit 9 bis 12 Wörtern. Schon da musstest du sorgfältig arbeiten, um kein Bigramm zu übersehen. Ein einziges Buch hat leicht 50 000 Wörter, also fast genauso viele Bigramme. Sprachmodelle werden mit Textsammlungen trainiert, die noch sehr viel größer sind.
Von Hand ist das nicht zu schaffen. Ein Programm erledigt dieselbe Arbeit dagegen in Sekundenbruchteilen und verzählt sich nie. Der Ablauf bleibt aber genau derselbe, den du schon kennst: Text in Wörter zerlegen, Bigramme bilden, zählen, Wahrscheinlichkeiten berechnen.
Bei größeren Textkorpora ist eine Auszählung von Hand nicht mehr praktikabel. Man nutzt Software, die die Häufigkeiten automatisiert ermittelt.
4.3.2Ein größerer Korpus
Wir untersuchen einen Text aus fünf Zeilen über einen Hund und eine Katze. Damit er gut lesbar bleibt, soll er auch im Programm auf mehrere Zeilen verteilt sein.
Einen Text über mehrere Zeilen schreibst du in
Python zwischen drei Anführungszeichen """
am Anfang und am Ende. Die Zeilenumbrüche gehören dann zum Text dazu.
Für split() ist ein Zeilenumbruch dasselbe wie ein
Leerzeichen:
text = """eins zwei
drei"""
print(text)
print(text.split())
eins zwei
drei
['eins', 'zwei', 'drei']4.3.3Schritt 1: Alle Folgewörter eines Wortes sammeln
Von Hand hast du für ein Vorgängerwort alle Bigramme gesucht, die mit
ihm beginnen, und dir jeweils das Folgewort notiert. Genau das macht die
Funktion folgewoerter. Sie bekommt die Wortliste und ein
Wort und liefert eine Liste mit allen Wörtern, die im
Text direkt nach diesem Wort stehen – auch die doppelten.
def folgewoerter(woerter, wort):
    folge = []
    for i in range(len(woerter) - 1):
        if woerter[i] == wort:
            folge.append(woerter[i + 1])
    return folge

korpus = """
der hund läuft im park der hund spielt mit dem ball
die katze sitzt auf dem baum die katze beobachtet den hund
der hund bellt laut der hund läuft zur katze
die katze springt vom baum die katze rennt weg
der hund läuft ihr hinterher der hund ist müde
"""
woerter = korpus.split()
print(len(woerter), "Wörter")
print(folgewoerter(woerter, "der"))
print(folgewoerter(woerter, "dem"))
49 Wörter
['hund', 'hund', 'hund', 'hund', 'hund', 'hund']
['ball', 'baum']- Zeilen 1–6: Die Funktion geht mit
ialle Positionen durch, auf die noch ein Wort folgt. Steht an Positionidas gesuchte Wort, wird das Wort an Positioni + 1in die Listefolgeaufgenommen. Das ist das „Fenster“ aus zwei Wörtern, nur dass jetzt bloß die Fenster beachtet werden, die mitwortbeginnen. - Zeilen 8–14: Der Korpus als mehrzeiliger Text.
- Zeile 15:
split()zerlegt den Text in eine Liste mit 49 Wörtern. Also gibt es 48 Bigramme. - Zeilen 17–18: Nach „der“ steht im ganzen Text sechsmal „hund“ und sonst nichts. Nach „dem“ steht einmal „ball“ und einmal „baum“.
Die Länge dieser Liste ist genau die Anzahl der Bigramme, die mit dem Wort beginnen. Das ist die Zahl, die du für die Wahrscheinlichkeit im Nenner brauchst. Auch der Sonderfall „letztes Wort“ ist automatisch richtig, denn die Schleife schaut nur Positionen an, auf die noch ein Wort folgt.
4.3.4Schritt 2: Häufigkeiten zählen
Die Liste ['ball', 'baum'] ist noch keine Tabelle. Für
die Tabelle brauchen wir jedes Folgewort einmal und
daneben seine Anzahl – wie bei der Strichliste. Dafür gibt es zwei
kleine Hilfsfunktionen, die du in ähnlicher Form schon geschrieben
hast:
def ohne_doppelte(liste):
    ergebnis = []
    for element in liste:
        if element not in ergebnis:
            ergebnis.append(element)
    return ergebnis

def zaehle(liste, gesucht):
    anzahl = 0
    for element in liste:
        if element == gesucht:
            anzahl += 1
    return anzahl

def zeige_tabelle(woerter, wort):
    folge = folgewoerter(woerter, wort)
    print("Mögliche Folgewörter nach", wort)
    for kandidat in ohne_doppelte(folge):
        print(f"  {kandidat}: {zaehle(folge, kandidat)}-mal")

zeige_tabelle(woerter, "der")
zeige_tabelle(woerter, "katze")
Mögliche Folgewörter nach der
hund: 6-mal
Mögliche Folgewörter nach katze
sitzt: 1-mal
beobachtet: 1-mal
die: 1-mal
springt: 1-mal
rennt: 1-mal- Zeilen 1–6:
ohne_doppelteliefert eine neue Liste, in der jedes Element nur einmal vorkommt, und zwar in der Reihenfolge seines ersten Auftretens. Das sind die Kandidaten für das nächste Wort. - Zeilen 8–13:
zaehlezählt, wie oftgesuchtin der Liste steht. - Zeilen 15–19:
zeige_tabellesetzt alles zusammen: Erst werden die Folgewörter gesammelt, dann wird für jeden Kandidaten die Anzahl ausgegeben. - Zeilen 21–22: Nach „der“ folgt immer „hund“. Nach
„katze“ folgen fünf verschiedene Wörter, jedes genau einmal. Dass auch
„die“ dabei ist, liegt an „zur katze die katze“: Zwischen der dritten
und vierten Zeile des Korpus gibt es keine Grenze,
split()macht aus allem eine einzige Wortliste.
Das Programm weiß nichts von Sätzen. Für die Analyse ist der Korpus eine lange Kette von Wörtern. Deshalb entstehen auch Bigramme über das Satzende hinweg, etwa „ball die“ oder „müde“ ganz am Ende ohne Nachfolger. Echte Sprachmodelle behandeln Satzzeichen und Satzgrenzen genauer. Für unser Modell vereinfachen wir das bewusst.
Rufe zeige_tabelle für das Wort „müde“ auf. Warum wird
nur die Überschrift ausgegeben? Rufe die Funktion auch mit einem Wort
auf, das im Text gar nicht vorkommt, zum Beispiel „maus“.
4.3.5Die Bigramm-Tabelle
Wenn man zeige_tabelle für jedes Wort des Korpus
aufruft, entsteht die vollständige Bigramm-Tabelle des
Modells. Ein Ausschnitt:
| Kontext | mögliche Folgewörter (Anzahl) |
|---|---|
| der | hund (6) |
| die | katze (4) |
| hund | ? |
| katze | sitzt (1), beobachtet (1), die (1), springt (1), rennt (1) |
| läuft | im (1), zur (1), ihr (1) |
| dem | ball (1), baum (1) |
| baum | die (2) |
Das Wort in der ersten Spalte, nach dem die Folgewörter gesucht werden, heißt Kontext. Bei einem Bigramm-Modell ist der Kontext ein einzelnes Wort, bei einem Trigramm-Modell ein Wortpaar.
So eine Tabelle ist eine Tabelle von Tabellen: Zu jedem Kontext gehört eine kleine eigene Tabelle aus Folgewort und Anzahl. Man kann sie sich wie ein Wörterbuch vorstellen: Unter dem Stichwort „dem“ schlägt man nach und findet dort „ball: 1, baum: 1“.
In vielen Programmiersprachen gibt es genau dafür einen eigenen Datentyp, das Dictionary (englisch für Wörterbuch). In der Python-Schreibweise sieht ein Ausschnitt der Tabelle so aus:
{"der":  {"hund": 6},
 "dem":  {"ball": 1, "baum": 1},
 "baum": {"die": 2}}
Vor jedem Doppelpunkt steht ein Stichwort, dahinter der Eintrag dazu. Der Eintrag ist selbst wieder ein kleines Wörterbuch. Deshalb spricht man von einem Dictionary von Dictionaries.
- Die Ergebnisse werden meist tabellarisch verwaltet: Zu jedem Kontext (z. B. einem Wort oder Wortpaar) wird eine Liste möglicher Folgewörter mit ihrer jeweiligen Häufigkeit bzw. Wahrscheinlichkeit gespeichert.
- Eine gängige Datenstruktur dafür ist ein Dictionary von
Dictionaries:
{kontext: {folgewort: anzahl}}.
Dictionaries brauchst du in diesem Skript nicht selbst zu programmieren. Unser Programm kommt mit Listen aus: Es speichert nicht die ganze Tabelle, sondern berechnet die Zeile für ein Wort jedes Mal neu, wenn sie gebraucht wird. Das ist etwas langsamer, liefert aber genau dieselben Zahlen.
Gib mit dem Programm für die Wörter „die“ und „hund“ jeweils aus, welche Folgewörter mit welcher Häufigkeit vorkommen. Ergänze damit die fehlende Zeile „hund“ in der Tabelle oben.
Ergebnis:
Lösung vergleichen
Mit den Funktionen aus diesem Abschnitt genügen zwei Aufrufe:
zeige_tabelle(woerter, "die")
zeige_tabelle(woerter, "hund")
Mögliche Folgewörter nach die
katze: 4-mal
Mögliche Folgewörter nach hund
läuft: 3-mal
spielt: 1-mal
der: 1-mal
bellt: 1-mal
ist: 1-malDie fehlende Tabellenzeile lautet: hund → läuft (3), spielt (1), der (1), bellt (1), ist (1). Insgesamt beginnen 7 Bigramme mit „hund“. Das Folgewort „der“ stammt aus „den hund der hund“ über die Zeilengrenze hinweg.
4.3.6Schritt 3: Wahrscheinlichkeiten berechnen
Für die Wahrscheinlichkeit teilst du die Anzahl eines Folgewortes
durch die Anzahl aller Bigramme, die mit dem Kontext
beginnen. Diese Zahl ist die Länge der Liste
folgewoerter(woerter, wort). Für „hund“ gilt zum Beispiel
.
Das Programm soll das für alle Kandidaten eines Wortes ausrechnen. Dabei entstehen zwei Listen, die zusammengehören wie die zwei Spalten einer Tabelle: eine Liste mit den Kandidaten und eine mit ihren Wahrscheinlichkeiten. Das Element an Stelle 0 der einen Liste gehört zum Element an Stelle 0 der anderen Liste, und so weiter.
| Index | 0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|
| Kandidaten | läuft | spielt | der | bellt | ist |
| Wahrscheinlichkeiten | ? | ? | ? | ? | ? |
Schreibe eine Funktion
wahrscheinlichkeiten(woerter, wort), die für ein gegebenes
Wort eine Liste mit den Wahrscheinlichkeiten seiner Folgewörter
zurückgibt, und zwar in derselben Reihenfolge wie
ohne_doppelte(folgewoerter(woerter, wort)). Die
Wahrscheinlichkeit ist die Anzahl des Folgewortes geteilt durch die
Gesamtanzahl aller Folgewörter zu diesem Wort. Runde auf zwei
Nachkommastellen.
Teste die Funktion mit „der“, „die“ und „hund“ und fülle damit die Tabelle oben aus.
Lösung vergleichen
def wahrscheinlichkeiten(woerter, wort):
    folge = folgewoerter(woerter, wort)
    ergebnis = []
    for kandidat in ohne_doppelte(folge):
        anteil = zaehle(folge, kandidat) / len(folge)
        ergebnis.append(round(anteil, 2))
    return ergebnis

print(ohne_doppelte(folgewoerter(woerter, "der")))
print(wahrscheinlichkeiten(woerter, "der"))
print(ohne_doppelte(folgewoerter(woerter, "die")))
print(wahrscheinlichkeiten(woerter, "die"))
print(ohne_doppelte(folgewoerter(woerter, "hund")))
print(wahrscheinlichkeiten(woerter, "hund"))
['hund']
[1.0]
['katze']
[1.0]
['läuft', 'spielt', 'der', 'bellt', 'ist']
[0.43, 0.14, 0.14, 0.14, 0.14]len(folge) ist die Anzahl aller Bigramme, die mit
wort beginnen – also genau der Nenner. Für „hund“:
und
.
Die gerundeten Werte ergeben zusammen
.
Die kleine Abweichung von 1 entsteht nur durch das Runden. Kommt das
Wort im Text nicht vor oder nur als letztes Wort, ist folge
leer. Dann läuft die Schleife kein einziges Mal, und die Funktion gibt
die leere Liste [] zurück – es wird also nie durch 0
geteilt.
4.3.7SoekiaGPT: Textanalyse im Browser
Für das Arbeiten mit größeren Textsammlungen gibt es Lernprogramme, die dir die n-Gramme und ihre Häufigkeiten anschaulich zeigen. Der Lehrplan empfiehlt SoekiaGPT. Es läuft im Browser: www.soekia.ch/GPT.
In SoekiaGPT kannst du eine vorgegebene Textsammlung auswählen (zum Beispiel Märchen); je nach Version kannst du auch eigene Texte hinzufügen. Das Programm analysiert die Sammlung und zeigt dir die gefundenen n-Gramme mit ihren Häufigkeiten. Gibst du einen Satzanfang ein, zeigt es dir die möglichen Folgewörter und setzt den Text Wort für Wort fort. Die genaue Gestaltung der Oberfläche kann sich von Version zu Version ändern. Lass dich davon nicht verwirren: Das Prinzip ist dasselbe wie in deinem Python-Programm.
Beide Zugänge ergänzen sich: SoekiaGPT zeigt das Verfahren anschaulich an größeren, echten Textsammlungen. Dein Python-Programm zeigt dir, was dabei „unter der Haube“ passiert.
Öffne SoekiaGPT im Browser.
- Wähle eine der vorgegebenen Textsammlungen aus. Suche die Anzeige der n-Gramme und notiere drei Bigramme, die besonders häufig vorkommen.
- Gib einen kurzen Satzanfang ein, der zur Textsammlung passt, und lass dir mögliche Folgewörter anzeigen. Notiere den Satzanfang und zwei vorgeschlagene Folgewörter.
- Beschreibe in zwei bis drei Sätzen, welche Schritte deines Python-Programms du in SoekiaGPT wiedererkennst.
Meine Beobachtungen:
Lösung vergleichen
Die Ergebnisse hängen von der gewählten Textsammlung ab. Worauf es ankommt:
- Unter den häufigsten Bigrammen sind meist kurze, sehr gebräuchliche Wortpaare aus Artikeln, Präpositionen und Bindewörtern (in Märchen z. B. Verbindungen mit „und“ oder „der“). Inhaltswörter wie Namen kommen seltener vor.
- Die vorgeschlagenen Folgewörter sind Wörter, die in der Textsammlung tatsächlich nach dem eingegebenen Satzanfang (bzw. seinem letzten Wort oder seinen letzten Wörtern) stehen. Häufigere Folgewörter werden eher vorgeschlagen.
- Wiedererkennen lassen sich: das Zerlegen der Texte in Wörter (wie
split()), das Bilden und Zählen der n-Gramme (wiefolgewoerterundzaehle) und das Ermitteln der möglichen Folgewörter zu einem Kontext mit ihren Häufigkeiten bzw. Wahrscheinlichkeiten (wiezeige_tabelleundwahrscheinlichkeiten).
4.3.8Übungen
Suche dir einen eigenen, etwas längeren Text: ein paar Sätze aus einem Buch, eine Zusammenfassung eines Liedtextes in eigenen Worten oder etwas frei Erfundenes. Schreibe ihn klein und ohne Satzzeichen in einen mehrzeiligen Text und analysiere ihn mit den Funktionen aus diesem Abschnitt.
Welches Wort hat die meisten unterschiedlichen Folgewörter? Schreibe ein Programm, das dieses Wort findet.
So kannst du vorgehen: Gehe mit einer Schleife über alle verschiedenen Wörter des Textes. Berechne für jedes Wort, wie viele unterschiedliche Folgewörter es hat. Das größte Ergebnis findest du wie das Maximum in einer Liste. Der Anfang könnte so aussehen:
for wort in ohne_doppelte(meine_woerter):
    anzahl = len(ohne_doppelte(folgewoerter(meine_woerter, wort)))
Lösung vergleichen
mein_text = """
am montag gehe ich ins kino und danach gehe ich essen
am dienstag gehe ich zum training und danach schlafe ich
am mittwoch lese ich ein buch und danach gehe ich schwimmen
"""
meine_woerter = mein_text.split()

bestes_wort = ""
beste_anzahl = 0
for wort in ohne_doppelte(meine_woerter):
    anzahl = len(ohne_doppelte(folgewoerter(meine_woerter, wort)))
    if anzahl > beste_anzahl:
        bestes_wort = wort
        beste_anzahl = anzahl

print(bestes_wort, "hat", beste_anzahl, "verschiedene Folgewörter:")
print(ohne_doppelte(folgewoerter(meine_woerter, bestes_wort)))
ich hat 6 verschiedene Folgewörter:
['ins', 'essen', 'zum', 'am', 'ein', 'schwimmen']Das Programm geht jedes verschiedene Wort einmal durch, zählt seine
unterschiedlichen Folgewörter und merkt sich das Wort mit der größten
Anzahl – wie bei der Suche nach dem Maximum. Für den Hund-Katze-Korpus
von oben liefert dasselbe Programm „hund“ mit 5 verschiedenen
Folgewörtern. „katze“ hat ebenfalls 5. Bei Gleichstand gewinnt hier das
Wort, das zuerst im Text vorkommt, weil nur bei >
ersetzt wird.
Typischerweise haben häufige „kleine“ Wörter wie „ich“, „und“ oder „der“ die meisten verschiedenen Folgewörter, denn nach ihnen kann vieles stehen.
4.3.9Weitere Übungen
Hier kannst du das Gelernte weiter üben. Die Punkte im Titel zeigen, wie schwer eine Aufgabe ist: ●○○ leicht, ●●○ mittel, ●●● knifflig. Fang mit den leichten an.
Für die Programmieraufgaben brauchst du die Funktionen
folgewoerter, ohne_doppelte und
zaehle und die Wortliste woerter des
Hund-Katze-Korpus aus diesem Abschnitt. Schreibe deine Programme in
derselben Datei darunter.
- Ein Jugendbuch hat 60 000 Wörter. Bestimme, wie viele Bigramme es enthält.
- Nenne zwei Gründe, warum man die Bigramme eines solchen Buches nicht von Hand auszählt.
Meine Antworten:
Lösung vergleichen
- Es gibt ein Bigramm weniger als Wörter: Bigramme.
- Zum Beispiel: Das Auszählen von Hand würde viel zu lange dauern. Bei so vielen Bigrammen verzählt man sich leicht oder übersieht welche. Eine Software ermittelt die Häufigkeiten dagegen automatisiert, schnell und ohne Zählfehler.
Ein Programm hat einen Korpus analysiert. Ein Ausschnitt seiner
Bigramm-Tabelle in der Schreibweise
{kontext: {folgewort: anzahl}}:
{"ich":   {"gehe": 3, "bleibe": 1},
 "gehe":  {"heute": 2, "morgen": 1},
"heute": {"ins": 2}}- Nenne alle Kontexte in diesem Ausschnitt.
- Nenne die Folgewörter von „gehe“ mit ihren Häufigkeiten.
- Wie viele Bigramme beginnen mit „ich“?
- Berechne die Wahrscheinlichkeit, dass auf „ich“ das Wort „gehe“ folgt.
- Mit welcher Wahrscheinlichkeit folgt auf „heute“ das Wort „ins“?
Meine Antworten:
Lösung vergleichen
- Die Kontexte sind „ich“, „gehe“ und „heute“ (jeweils vor dem Doppelpunkt der äußeren Klammer).
- „heute“ (2-mal) und „morgen“ (1-mal).
- Bigramme.
- .
- Auf „heute“ folgt in diesem Ausschnitt nur „ins“: .
So liest du die Schreibweise: Hinter jedem Kontext steht in geschweiften Klammern seine eigene kleine Tabelle aus Folgewort und Anzahl.
Bestimme ohne Computer die Ausgabe des Programms. Erkläre dann, warum zwei der Listen leer sind, und zwar aus verschiedenen Gründen.
schule = "wir lernen mathe wir lernen englisch wir chillen"
woerter_schule = schule.split()
print(folgewoerter(woerter_schule, "wir"))
print(folgewoerter(woerter_schule, "lernen"))
print(folgewoerter(woerter_schule, "chillen"))
print(folgewoerter(woerter_schule, "schule"))
Ausgabe und Erklärung:
Lösung vergleichen
print(folgewoerter(woerter_schule, "wir"))
print(folgewoerter(woerter_schule, "lernen"))
print(folgewoerter(woerter_schule, "chillen"))
print(folgewoerter(woerter_schule, "schule"))
['lernen', 'lernen', 'chillen']
['mathe', 'englisch']
[]
[]- Nach „wir“ steht zweimal „lernen“ und einmal „chillen“. Doppelte Folgewörter bleiben in der Liste.
- „chillen“ kommt vor, aber nur als letztes Wort. Danach steht nichts mehr, also gibt es kein Bigramm, das mit „chillen“ beginnt.
- „schule“ kommt in der Wortliste gar nicht vor. Das
Wort steckt zwar im Variablennamen
schule, aber das spielt keine Rolle: Gesucht wird in der Listewoerter_schule.
Gegeben ist der Textkorpus:
tom spielt fußball lea spielt tennis tom spielt tennis
- Stelle die vollständige Bigramm-Tabelle in der Schreibweise
{kontext: {folgewort: anzahl}}auf. - Berechne die Wahrscheinlichkeiten aller Folgewörter von „spielt“.
Meine Tabelle und meine Rechnung:
Lösung vergleichen
Die 8 Bigramme sind: tom spielt · spielt fußball · fußball lea · lea spielt · spielt tennis · tennis tom · tom spielt · spielt tennis.
{"tom":     {"spielt": 2},
 "spielt":  {"fußball": 1, "tennis": 2},
 "fußball": {"lea": 1},
 "lea":     {"spielt": 1},
 "tennis":  {"tom": 1}}
Mit „spielt“ beginnen Bigramme: „fußball“ hat , „tennis“ hat .
„tennis“ kommt zweimal vor. Das zweite „tennis“ ist aber das letzte
Wort, deshalb steht bei „tennis“ nur {"tom": 1}. Kontrolle:
Alle Anzahlen zusammen ergeben
.
Ben hat die Funktion folgewoerter aus dem Gedächtnis
aufgeschrieben. Beim ersten Aufruf klappt alles, beim zweiten nicht:
def folgewoerter_ben(woerter, wort):
    folge = []
    for i in range(len(woerter)):
        if woerter[i] == wort:
            folge.append(woerter[i + 1])
    return folge

test = "der hund bellt der hund schläft".split()
print(folgewoerter_ben(test, "der"))
print(folgewoerter_ben(test, "schläft"))
['hund', 'hund']IndexError: list index out of range- Erkläre, warum der erste Aufruf funktioniert und der zweite zu einem Fehler führt.
- Beschreibe, wie Ben den Fehler behebt.
Meine Erklärung:
Lösung vergleichen
- In Zeile 3 läuft
ibis zum letzten Index, hier 5. Beim Aufruf mit „der“ ist das kein Problem: „der“ steht nur an den Stellen 0 und 3, undwoerter[1]undwoerter[4]gibt es. „schläft“ steht aber an der letzten Stelle 5. Dann versucht Zeile 5,woerter[6]zu lesen – dieses Element gibt es nicht. Python meldetIndexError: list index out of range. - Die Schleife darf nur bis zum vorletzten Index laufen:
for i in range(len(woerter) - 1):. Dann wird das letzte Wort nie als Kontext untersucht, und die Funktion liefert für „schläft“ die leere Liste[].
Der Fehler ist tückisch, weil er nur auftritt, wenn das gesuchte Wort am Ende des Textes steht. Teste deshalb Funktionen immer auch mit dem letzten Wort.
Bei der Textkörperanalyse kann man auch Unigramme zählen, also einzelne Wörter. Schreibe ein Programm, das im Hund-Katze-Korpus
- ausgibt, wie viele verschiedene Wörter der Korpus enthält,
- das Wort findet, das am häufigsten vorkommt, und es mit seiner Anzahl ausgibt.
Verwende ohne_doppelte und zaehle.
Gehe mit einer Schleife über ohne_doppelte(woerter) und
merke dir das bisher häufigste Wort und seine Anzahl – wie bei der Suche
nach dem Maximum.
Lösung vergleichen
verschiedene_woerter = ohne_doppelte(woerter)
print(len(verschiedene_woerter), "verschiedene Wörter")

bestes_wort = ""
beste_anzahl = 0
for wort in verschiedene_woerter:
    anzahl = zaehle(woerter, wort)
    if anzahl > beste_anzahl:
        bestes_wort = wort
        beste_anzahl = anzahl
print("Am häufigsten:", bestes_wort, "mit", beste_anzahl, "Vorkommen")
27 verschiedene Wörter
Am häufigsten: hund mit 7 Vorkommen- Zeilen 1–2:
ohne_doppelteliefert jedes Wort einmal. Die Länge dieser Liste ist die Anzahl der verschiedenen Wörter (Unigramme). - Zeilen 4–10: Für jedes verschiedene Wort wird gezählt, wie oft es in der ganzen Wortliste steht. Ist die Anzahl größer als die bisher beste, merkt sich das Programm dieses Wort.
„hund“ kommt sechsmal nach „der“ und einmal nach „den“ vor. Auf Platz
zwei liegt „der“ mit 6. Typischer Fehler:
zaehle(verschiedene_woerter, wort) statt
zaehle(woerter, wort). In der Liste ohne Doppelte kommt
jedes Wort nur einmal vor, dann ist jede Anzahl 1.
Schreibe eine Funktion
wahrscheinlichkeit(woerter, wort, folgewort), die die
Wahrscheinlichkeit zurückgibt, dass auf wort das Wort
folgewort folgt, gerundet auf zwei Nachkommastellen. Hat
wort keine Folgewörter (es kommt nicht vor oder nur als
letztes Wort), soll die Funktion 0 zurückgeben.
Teste mit dem Hund-Katze-Korpus:
- „hund“ → „läuft“ (erwartet: ),
- „dem“ → „baum“,
- „katze“ → „bellt“,
- „maus“ → „läuft“ und „müde“ → „ist“.
Lösung vergleichen
def wahrscheinlichkeit(woerter, wort, folgewort):
    folge = folgewoerter(woerter, wort)
    if len(folge) == 0:
        return 0
    return round(zaehle(folge, folgewort) / len(folge), 2)

print(wahrscheinlichkeit(woerter, "hund", "läuft"))
print(wahrscheinlichkeit(woerter, "dem", "baum"))
print(wahrscheinlichkeit(woerter, "katze", "bellt"))
print(wahrscheinlichkeit(woerter, "maus", "läuft"))
print(wahrscheinlichkeit(woerter, "müde", "ist"))
0.43
0.5
0.0
0
0- Zeile 2:
folgeenthält alle Folgewörter vonwort. Ihre Länge ist der Nenner. - Zeilen 3–4: Ist die Liste leer, wird sofort
0zurückgegeben. Ohne diese Prüfung würde Python bei „maus“ durch 0 teilen und mitZeroDivisionErrorabbrechen. - Zeile 5: Anzahl des Folgewortes geteilt durch die Anzahl aller Folgewörter.
„katze“ kommt vor, aber „bellt“ nie danach:
.
Python schreibt das Ergebnis einer Division immer als Kommazahl, deshalb
0.0. „müde“ ist das letzte Wort und hat keine Folgewörter,
deshalb kommt wie bei „maus“ die 0 aus Zeile 4.
4.3.10Das Wichtigste in Kürze
- Große Textkorpora werden nicht von Hand, sondern automatisiert mit Software analysiert.
folgewoerter(woerter, wort)sammelt alle Wörter, die direkt nachwortstehen. Die Länge dieser Liste ist der Nenner für die Wahrscheinlichkeit.- Mit
ohne_doppelteundzaehleentsteht daraus eine Zeile der Bigramm-Tabelle: Kandidaten mit ihren Häufigkeiten. - Das Wort, nach dessen Folgewörtern gesucht wird, heißt Kontext.
- Die Ergebnisse werden tabellarisch verwaltet. Eine
gängige Datenstruktur dafür ist ein Dictionary von
Dictionaries
{kontext: {folgewort: anzahl}}. Unser Programm bildet die Tabelle mit Listen nach. - SoekiaGPT zeigt n-Gramme, ihre Häufigkeiten und mögliche Folgewörter an größeren Textsammlungen.
4.4Texte erzeugen: next word prediction und Sampling DS33
Diesen Abschnitt als PDF (S. 42–58)
Das Jupyter-Notebook aus dem Unterricht: DS33_Textgenerierung_Sampling.ipynb. Herunterladen und in VS Code oder Jupyter öffnen.
Bisher hast du ein Sprachmodell nur trainiert: Du hast gezählt und Wahrscheinlichkeiten berechnet. Jetzt lässt du es schreiben. Die Idee ist verblüffend einfach: Das Modell schaut auf das letzte Wort, wählt mithilfe seiner Tabelle ein passendes nächstes Wort aus, hängt es an – und wiederholt das immer wieder. Spannend ist dabei die Frage, wie es unter mehreren möglichen Folgewörtern auswählt. Davon hängt ab, ob der Text eintönig, abwechslungsreich oder unsinnig wird. Auch die Trainingstexte und die Länge der n-Gramme verändern das Ergebnis deutlich.
Nach diesem Abschnitt kannst du
- beschreiben, wie ein n-Gramm-Modell Wort für Wort einen Text erzeugt (next word prediction),
- die Sampling-Strategien greedy, random und top-k benennen und von Hand anwenden,
- Textgenerierung mit greedy, random und top-k in Python umsetzen und vergleichen,
- beschreiben, wie sich die Länge der n-Gramme auf den erzeugten Text auswirkt,
- erläutern, wie der erzeugte Text von den Trainingsdaten abhängt.
4.4.1Vom Modell zum Text
Ein Text entsteht beim n-Gramm-Modell Wort für Wort. Man gibt ein Startwort vor. Dann wiederholt das Modell immer dieselben drei Schritte:
- Schaue in der Tabelle nach, welche Wörter auf das letzte Wort folgen können.
- Wähle eines dieser Folgewörter aus.
- Hänge es an den Text an. Es ist jetzt das neue letzte Wort.
Das Modell sagt also immer nur das nächste Wort voraus. Auf Englisch heißt das next word prediction. Hat das letzte Wort keine Folgewörter (weil es im Korpus nur ganz am Ende steht), bricht das Verfahren ab.
Textgenerierung ist das Erzeugen eines neuen Textes durch ein Sprachmodell. Bei der next word prediction (Vorhersage des nächsten Wortes) bestimmt das Modell aus dem bisherigen Text ein passendes nächstes Wort.
Textgenerierung (next word prediction): Ausgehend von einem Startwort bzw. Startkontext wird mithilfe der n-Gramm-Tabelle immer wieder das nächste Wort bestimmt und an den Text angehängt.
Die naheliegendste Art, ein Folgewort auszuwählen: Man nimmt immer das wahrscheinlichste. Probiere das zuerst von Hand aus.
Verwende die Bigramm-Tabelle zum Hund-Katze-Korpus aus dem Abschnitt Textanalyse mit dem Computer („der hund läuft im park der hund spielt mit dem ball …“). Die Zeilen, die du brauchst, findest du dort in der Tabelle und in deinem Ergebnis zum Auftrag Eigene Analyse (Zeile „hund“). Für „im“ und „park“ gilt: Auf „im“ folgt immer „park“, auf „park“ immer „der“.
Beginne beim Wort „der“. Wähle jeweils das wahrscheinlichste Folgewort, bis du 5 Wörter notiert hast. Haben mehrere Folgewörter die gleiche Wahrscheinlichkeit, nimm das, das in der Tabelle zuerst steht.
Mein Text aus 5 Wörtern:
Lösung vergleichen
der hund läuft im park
- Auf „der“ folgt immer „hund“ (6 von 6).
- Auf „hund“ ist „läuft“ am wahrscheinlichsten (3 von 7).
- Auf „läuft“ folgen „im“, „zur“ und „ihr“ je einmal. Bei Gleichstand gilt die Regel aus der Aufgabe: „im“ steht zuerst.
- Auf „im“ folgt immer „park“.
Später vergleichst du dieses Ergebnis mit dem Python-Programm. Es muss dasselbe herauskommen.
4.4.2Sampling: Wie wird das Folgewort ausgewählt?
Oft gibt es mehrere mögliche Folgewörter. Die Art, wie das Modell eines davon auswählt, heißt Sampling-Strategie (englisch sample = Stichprobe, Probe ziehen). Wir betrachten drei Strategien an einem kleinen Korpus über das Wochenende:
ich esse pizza     ich spiele fußball   ich esse eis
ich lese comics    ich spiele schach    ich esse pizza
ich schlafe lange  ich lese bücher      ich spiele fußball
ich esse nudeln
Das Wort „ich“ kommt zehnmal vor, und immer folgt ein Wort: viermal „esse“, dreimal „spiele“, zweimal „lese“ und einmal „schlafe“. Daraus ergeben sich diese Wahrscheinlichkeiten:
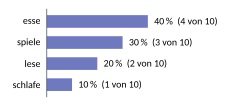
Sampling ist die Auswahl des nächsten Wortes aus den möglichen Folgewörtern. Die Sampling-Strategie legt fest, wie ausgewählt wird.
Greedy: immer das wahrscheinlichste Wort
Bei der Strategie greedy (englisch für „gierig“) nimmt das Modell immer das Wort mit dem längsten Balken. Nach „ich“ kommt also jedes Mal „esse“. Der Name passt: Das Modell greift immer sofort nach dem größten Stück, ohne an später zu denken. Den Begriff „gierig“ kennst du vielleicht schon vom Problemlösen mit Heuristiken.
Greedy ist deterministisch: Gleiches Startwort, gleicher Text – jedes Mal. Das hat einen Nachteil. Im Wochenend-Korpus folgt auf „esse“ am häufigsten „pizza“, auf „pizza“ immer „ich“, und auf „ich“ wieder „esse“. Der Text dreht sich im Kreis: „ich esse pizza ich esse pizza ich esse pizza …“. Die Wörter „spiele“, „lese“ und „schlafe“ kommen nie vor, obwohl sie zusammen sogar häufiger sind als „esse“.
Random: Auslosen nach Wahrscheinlichkeit
Bei der Strategie random (englisch für „zufällig“) wird das Folgewort ausgelost. Dabei bekommt aber nicht jedes Wort die gleiche Chance. Häufige Wörter sollen öfter gezogen werden als seltene. Man sagt: Die Auswahl ist gewichtet nach der Wahrscheinlichkeit.
Das kannst du dir wie eine Lostrommel vorstellen. Für jedes Bigramm im Korpus kommt ein Los hinein. Nach „ich“ sind das 10 Lose: 4 mit „esse“, 3 mit „spiele“, 2 mit „lese“ und 1 mit „schlafe“. Wer blind ein Los zieht, erwischt „esse“ mit der Wahrscheinlichkeit – genau wie in der Tabelle.
Mit einem Zehnerwürfel oder einem Zufallszahlengenerator geht das auch ohne Trommel: Ziehe eine Zufallszahl von 1 bis 10 und schau nach, welches Wort auf diesem Los steht. Die Zahlen 1 bis 4 bedeuten „esse“, 5 bis 7 „spiele“, 8 und 9 „lese“ und 10 „schlafe“.
Random ist nicht deterministisch: Jeder Durchlauf kann einen anderen Text liefern. Die Texte werden abwechslungsreicher. Aber auch seltene Folgewörter kommen manchmal dran, und dann kann der Text seltsam werden.
Top-k: nur unter den besten k auslosen
Die Strategie top-k ist ein Kompromiss. Zuerst werden nur die wahrscheinlichsten Folgewörter behalten, alle anderen fliegen raus. Unter den übrigen wird dann wie bei random gewichtet ausgelost. Die Zahl legt man vorher fest.
Bei top-2 bleiben nach „ich“ nur „esse“ und „spiele“ übrig. In der Lostrommel liegen jetzt nur noch 4 + 3 = 7 Lose. Die Wahrscheinlichkeiten ändern sich deshalb: „esse“ hat und „spiele“ .
Mit bleibt nur das wahrscheinlichste Wort übrig – das ist greedy. Ist mindestens so groß wie die Zahl aller Folgewörter, wird nichts gestrichen – das ist random. Top-k liegt also zwischen den beiden anderen Strategien.
Sampling-Strategien legen fest, wie aus mehreren möglichen Folgewörtern eines ausgewählt wird:
- Greedy: Es wird immer das wahrscheinlichste Folgewort gewählt → deterministisch, aber oft eintönig und sich wiederholend.
- Random: Es wird zufällig unter allen möglichen Folgewörtern gewählt, gewichtet nach ihrer Wahrscheinlichkeit → abwechslungsreicher, aber manchmal unsinnig.
- Top-k: Es werden nur die wahrscheinlichsten Folgewörter betrachtet, unter denen dann zufällig (gewichtet) ausgewählt wird → Kompromiss zwischen Vorhersagbarkeit und Abwechslung.
So beschreibst du die Strategien in Fachsprache:
- „Greedy nimmt das Beste.“ → „Bei greedy wird stets das Folgewort mit der höchsten Wahrscheinlichkeit gewählt.“
- „Random würfelt.“ → „Bei random wird das Folgewort zufällig ausgewählt, wobei häufigere Folgewörter mit höherer Wahrscheinlichkeit gezogen werden.“
Verwende die Folgewörter nach „ich“ aus dem Wochenend-Korpus (4 × esse, 3 × spiele, 2 × lese, 1 × schlafe).
- Welches Wort wählt greedy?
- Bei random werden nacheinander die Zufallszahlen 7, 2, 10 und 9 gezogen (Lose wie in der Abbildung). Welche Wörter werden gewählt?
- Bei top-2 sind die Lose 1 bis 4 „esse“ und 5 bis 7 „spiele“. Welche Wörter werden bei den Zufallszahlen 5 und 3 gewählt?
- Berechne die Wahrscheinlichkeiten der Folgewörter bei top-3 und zeichne ein Balkendiagramm.
Meine Antworten und mein Balkendiagramm:
Lösung vergleichen
- Greedy wählt immer „esse“ (40 % ist die höchste Wahrscheinlichkeit).
- 7 → „spiele“, 2 → „esse“, 10 → „schlafe“, 9 → „lese“.
- 5 → „spiele“, 3 → „esse“.
- Bei top-3 wird „schlafe“ gestrichen. Es bleiben Lose:
| Folgewort | Lose | Wahrscheinlichkeit |
|---|---|---|
| esse | 4 | % |
| spiele | 3 | % |
| lese | 2 | % |
| schlafe | – | gestrichen |
Kontrolle: . Das Balkendiagramm zeigt dieselbe Reihenfolge wie vorher, nur sind die Balken länger, weil die gestrichene Wahrscheinlichkeit auf die übrigen Wörter verteilt wird.
4.4.3Textgenerierung in Python
Jetzt bringen wir das alles in ein Programm. Wir brauchen die Funktionen aus dem Abschnitt Textanalyse mit dem Computer. Sie stehen hier noch einmal zusammen mit dem Hund-Katze-Korpus:
def folgewoerter(woerter, wort):
    folge = []
    for i in range(len(woerter) - 1):
        if woerter[i] == wort:
            folge.append(woerter[i + 1])
    return folge

def ohne_doppelte(liste):
    ergebnis = []
    for element in liste:
        if element not in ergebnis:
            ergebnis.append(element)
    return ergebnis

def zaehle(liste, gesucht):
    anzahl = 0
    for element in liste:
        if element == gesucht:
            anzahl += 1
    return anzahl

korpus = """
der hund läuft im park der hund spielt mit dem ball
die katze sitzt auf dem baum die katze beobachtet den hund
der hund bellt laut der hund läuft zur katze
die katze springt vom baum die katze rennt weg
der hund läuft ihr hinterher der hund ist müde
"""
woerter = korpus.split()
Dieses Programm gibt noch nichts aus. Es stellt nur die Werkzeuge und die Wortliste bereit. Alle folgenden Programme in diesem Abschnitt bauen darauf auf: Schreibe sie in derselben Datei darunter.
Greedy in Python
Die Funktion für greedy sucht unter den Kandidaten den mit der größten Anzahl. Das ist dieselbe Idee wie die Suche nach dem Maximum in einer Liste:
def naechstes_wort_greedy(woerter, wort):
    folge = folgewoerter(woerter, wort)
    if len(folge) == 0:
        return ""
    bestes = ""
    beste_anzahl = 0
    for kandidat in ohne_doppelte(folge):
        anzahl = zaehle(folge, kandidat)
        if anzahl > beste_anzahl:
            bestes = kandidat
            beste_anzahl = anzahl
    return bestes

print(naechstes_wort_greedy(woerter, "hund"))
print(naechstes_wort_greedy(woerter, "läuft"))
print(naechstes_wort_greedy(woerter, "müde"), "<- leer")
läuft
im
<- leer- Zeilen 2–4: Hat das Wort keine Folgewörter, gibt
die Funktion die leere Zeichenkette
""zurück. Daran erkennt das aufrufende Programm später, dass es nicht weitergeht. - Zeilen 5–11: Die Kandidaten werden der Reihe nach durchgegangen. Nur wenn ein Kandidat mehr Vorkommen hat als der bisher beste, wird er der neue beste. Bei Gleichstand bleibt der frühere Kandidat. Deshalb gewinnt nach „läuft“ das Wort „im“: Es steht unter den gleich häufigen Wörtern im Text zuerst.
- Zeile 16: „müde“ ist das letzte Wort des Korpus.
Die Funktion gibt
""zurück, deshalb steht vor dem Pfeil nichts.
Random in Python: die Lostrommel
Für random brauchen wir die Lostrommel. Und die haben wir schon! Die
Liste folgewoerter(woerter, wort) enthält jedes Folgewort
so oft, wie es im Text vorkommt – also genau ein Los
pro Bigramm. Wir müssen nur eine zufällige Stelle dieser Liste
auswählen:
import random

def naechstes_wort_random(woerter, wort):
    folge = folgewoerter(woerter, wort)
    if len(folge) == 0:
        return ""
    nummer = random.randint(0, len(folge) - 1)
    return folge[nummer]

print(folgewoerter(woerter, "hund"))
print(naechstes_wort_random(woerter, "hund"))
print(naechstes_wort_random(woerter, "hund"))
print(naechstes_wort_random(woerter, "hund"))
['läuft', 'spielt', 'der', 'bellt', 'läuft', 'läuft', 'ist']
läuft
der
läuftDie Ausgabe ab der zweiten Zeile ist nur ein Beispiel. Bei dir kommen andere Wörter heraus, und bei jedem Start andere.
- Zeile 1: Das Modul
randomwird eingebunden. - Zeile 7:
random.randint(0, len(folge) - 1)liefert eine zufällige ganze Zahl von 0 bis zum letzten Index der Liste, jede mit gleicher Wahrscheinlichkeit. Das ist das blinde Ziehen eines Loses. - Zeile 8: Das Wort an dieser Stelle wird zurückgegeben. Weil „läuft“ dreimal in der Liste steht, wird es mit der Wahrscheinlichkeit gezogen, jedes andere Wort mit . Die Auswahl ist also gewichtet, ohne dass wir die Wahrscheinlichkeiten ausrechnen müssen.
Mit dem folgenden Programm (unter die bisherigen Programme schreiben) lässt du 1000-mal ein Folgewort nach „hund“ auslosen und zählst, wie oft „läuft“ kam. Erwartet sind etwa Treffer. Starte es mehrmals.
treffer = 0
for versuch in range(1000):
    if naechstes_wort_random(woerter, "hund") == "läuft":
        treffer += 1
print(f"läuft wurde {treffer}-mal gezogen")
läuft wurde 437-mal gezogenDie Zahl schwankt von Start zu Start (hier ein Beispiel), liegt aber fast immer in der Nähe von 429.
Einen ganzen Text erzeugen
Jetzt fehlt nur noch die Schleife, die Wort für Wort anhängt. Die
Funktion generiere_text bekommt die Wortliste, ein
Startwort, die gewünschte Länge (Anzahl der Wörter) und den Namen der
Strategie als Zeichenkette:
def generiere_text(woerter, startwort, laenge, strategie):
    text = startwort
    aktuelles_wort = startwort
    for schritt in range(laenge - 1):
        if strategie == "greedy":
            naechstes = naechstes_wort_greedy(woerter, aktuelles_wort)
        else:
            naechstes = naechstes_wort_random(woerter, aktuelles_wort)
        if naechstes == "":
            break
        text = text + " " + naechstes
        aktuelles_wort = naechstes
    return text

print("Greedy:", generiere_text(woerter, "der", 10, "greedy"))
Greedy: der hund läuft im park der hund läuft im park- Zeilen 2–3: Der Text beginnt mit dem Startwort.
aktuelles_wortist das jeweils letzte Wort. - Zeile 4: Das Startwort ist schon da, also fehlen
noch
laenge - 1Wörter. - Zeilen 5–8: Je nach Strategie wird das nächste Wort mit greedy oder random bestimmt.
- Zeilen 9–10: Gibt es kein Folgewort, wird die
Schleife mit
breakvorzeitig beendet. Der Text ist dann kürzer als gewünscht. - Zeilen 11–12: Das neue Wort wird mit einem Leerzeichen angehängt und wird zum aktuellen Wort.
Die ersten fünf Wörter stimmen mit deinem Ergebnis aus dem Auftrag Von Hand: die ersten Schritte der Textgenerierung überein. Danach beginnt greedy wieder von vorn: Der Text läuft in einer Schleife, wie die Abbildung zeigt.
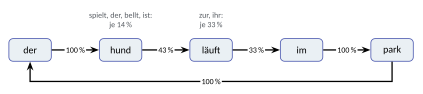
Und so sieht es mit random aus. Weil der Zufall mitspielt, sind die folgenden Ausgaben nur Beispiele:
print("Random:", generiere_text(woerter, "der", 10, "random"))
print("Random:", generiere_text(woerter, "der", 10, "random"))
print("Random:", generiere_text(woerter, "der", 10, "random"))
Random: der hund läuft zur katze rennt weg der hund läuft
Random: der hund spielt mit dem baum die katze sitzt auf
Random: der hund ist müdeIm zweiten Beispiel ist ein neuer Satz entstanden, der so nicht im Korpus steht: „der hund spielt mit dem baum“. Jedes einzelne Wortpaar kommt im Korpus vor, die Kombination aber nicht. Im dritten Beispiel bricht der Text nach vier Wörtern ab, weil „müde“ keine Folgewörter hat.
Wenn generiere_text einen NameError meldet,
etwa name 'naechstes_wort_random' is not defined, fehlt
eine der Funktionen in deiner Datei – oder sie steht
unter dem Aufruf. Python muss eine Funktion kennen,
bevor sie aufgerufen wird. Schreibe alle Funktionen an den Anfang der
Datei.
4.4.4Übungen zum Sampling
Führe das Programm mit den drei Random-Zeilen und der Greedy-Zeile mehrfach aus. Was fällt dir beim Vergleich der Greedy- und der Random-Ausgaben auf? Erkläre, warum greedy immer denselben Text liefert, random aber unterschiedliche.
Meine Beobachtung und Erklärung:
Lösung vergleichen
Beobachtung: Greedy liefert bei jedem Start genau denselben Text, „der hund läuft im park der hund läuft im park“. Er wiederholt sich ständig und benutzt nur fünf verschiedene Wörter. Die Random-Texte sind bei jedem Start anders und abwechslungsreicher, manchmal brechen sie früh ab („der hund ist müde“), manchmal entstehen neue, etwas seltsame Kombinationen wie „der hund spielt mit dem baum“.
Erklärung: Greedy wählt in jedem Schritt das Folgewort mit der höchsten Wahrscheinlichkeit. Es gibt keinen Zufall – gleiches Startwort, gleiche Tabelle, gleiches Ergebnis (deterministisch). Random lost das Folgewort gewichtet aus. Bei jedem Start werden andere Lose gezogen, deshalb entstehen andere Texte. Auch seltene Folgewörter haben eine Chance.
Implementiere eine Funktion
naechstes_wort_top_k(woerter, wort, k), die nur unter den
k häufigsten Folgewörtern zufällig auswählt, gewichtet nach
ihrer Häufigkeit. Teste sie mit „hund“ und
.
Schreibe außerdem eine Funktion
generiere_text_top_k(woerter, startwort, laenge, k), die
damit einen Text erzeugt.
Ein möglicher Weg:
- Lege zwei Listen an,
kandidaten(ohne Doppelte) undanzahlen, die zusammengehören wie die zwei Spalten einer Tabelle. - Wiederhole
-mal:
Suche die Position des größten Wertes in
anzahlen. Nimm das Wort und seine Anzahl mitpopaus beiden Listen heraus und lege so viele Lose dieses Wortes in eine neue Listelostrommel. - Ziehe zum Schluss ein zufälliges Los aus
lostrommel.
Lösung vergleichen
def naechstes_wort_top_k(woerter, wort, k):
    folge = folgewoerter(woerter, wort)
    if len(folge) == 0:
        return ""
    kandidaten = ohne_doppelte(folge)
    anzahlen = []
    for kandidat in kandidaten:
        anzahlen.append(zaehle(folge, kandidat))
    lostrommel = []
    for runde in range(min(k, len(kandidaten))):
        pos = 0
        for i in range(len(anzahlen)):
            if anzahlen[i] > anzahlen[pos]:
                pos = i
        bestes = kandidaten.pop(pos)
        anzahl = anzahlen.pop(pos)
        for los in range(anzahl):
            lostrommel.append(bestes)
    return lostrommel[random.randint(0, len(lostrommel) - 1)]

def generiere_text_top_k(woerter, startwort, laenge, k):
    text = startwort
    aktuelles_wort = startwort
    for schritt in range(laenge - 1):
        naechstes = naechstes_wort_top_k(woerter, aktuelles_wort, k)
        if naechstes == "":
            break
        text = text + " " + naechstes
        aktuelles_wort = naechstes
    return text

print(naechstes_wort_top_k(woerter, "hund", 2))
print(generiere_text_top_k(woerter, "der", 10, 2))
läuft
der hund läuft zur katze sitzt auf dem ball dieDie Ausgabe ist ein Beispiel. Nach „hund“ bleiben bei nur „läuft“ (3 Lose) und „spielt“ (1 Los) übrig. „spielt“ ist eines von vier gleich häufigen Wörtern und kommt durch, weil es im Text zuerst steht. Die Wahrscheinlichkeiten sind dann und .
- Zeilen 5–8: die beiden zusammengehörenden Listen.
- Zeile 10:
min(k, len(kandidaten))sorgt dafür, dass nicht mehr Runden laufen, als es Kandidaten gibt. - Zeilen 11–14: Suche der Position des Maximums. Bei Gleichstand bleibt die erste Position.
- Zeilen 15–18: Wort und Anzahl werden aus beiden Listen entfernt (damit in der nächsten Runde das zweitbeste gefunden wird), und das Wort kommt so oft in die Lostrommel, wie es vorkommt.
- Zeile 19: Ziehen eines Loses, wie bei random.
generiere_text_top_k ist eine Kopie von
generiere_text, in der nur die Auswahl des nächsten Wortes
ersetzt ist. Mit
entsteht derselbe Text wie bei greedy.
4.4.5Wie die Länge der n-Gramme den Text verändert
Bisher hat unser Modell nur auf ein Wort zurückgeschaut. Das ist der Grund für Sätze wie „der hund spielt mit dem baum“: Nach „dem“ weiß das Modell nicht mehr, dass vorher „spielt mit“ stand, und wählt „baum“ genauso oft wie „ball“.
Ein Trigramm-Modell schaut auf die letzten zwei Wörter. Nach „mit dem“ folgt im Korpus nur „ball“. Der seltsame Satz kann also nicht mehr entstehen. Der Text wird zusammenhängender – man sagt auch kohärenter.
Das hat aber einen Preis. Ein Kontext aus zwei Wörtern ist spezifischer: Er kommt seltener vor, und nach ihm gibt es weniger Auswahl. Im Hund-Katze-Korpus sieht das so aus:
| Bigramm-Modell | Trigramm-Modell | |
|---|---|---|
| Kontext | 1 Wort | 2 Wörter |
| verschiedene Kontexte mit Folgewort | 26 | 36 |
| davon mit nur einem möglichen Folgewort | 22 | 33 |
| davon mit Auswahl | 4 | 3 |
Beim Trigramm-Modell gibt es fast nirgends eine Auswahl. Der erzeugte Text ist dann fast immer ein Stück aus dem Korpus, Wort für Wort abgeschrieben. Er wird weniger variantenreich. Je länger die n-Gramme, desto stärker ist dieser Effekt. Außerdem findet ein Modell mit langen n-Grammen zu einem neuen Startkontext oft gar keine Fortsetzung, weil genau diese Wortfolge im Korpus nie vorkam.
Die Länge des n-Gramms beeinflusst die Textqualität: Größere (z. B. Trigramme statt Bigramme) erzeugen meist kohärentere, aber dafür weniger variantenreiche Texte, da der Kontext spezifischer ist und damit seltener im Korpus vorkommt.
Baue ein Trigramm-Modell, bei dem der Kontext aus einem Wortpaar besteht:
- Schreibe eine Funktion
folgewoerter_2(woerter, wort1, wort2), die alle Wörter sammelt, die im Korpus direkt nach dem Wortpaarwort1 wort2stehen. - Schreibe eine Funktion
generiere_text_trigramm(woerter, wort1, wort2, laenge), die ab dem Startpaar mit random-Sampling einen Text erzeugt. - Vergleiche die erzeugten Texte mit denen des Bigramm-Modells: Wirken sie mit Trigrammen „sinnvoller“? Warum kann die Trigramm-Generierung bei einem kleinen Korpus schneller abbrechen? Probiere dazu auch das Startpaar „der ball“ aus.
Deine Antworten zu Teil 3 (die Funktionen schreibst du am Computer):
Lösung vergleichen
def folgewoerter_2(woerter, wort1, wort2):
    folge = []
    for i in range(len(woerter) - 2):
        if woerter[i] == wort1 and woerter[i + 1] == wort2:
            folge.append(woerter[i + 2])
    return folge

def generiere_text_trigramm(woerter, wort1, wort2, laenge):
    text = wort1 + " " + wort2
    for schritt in range(laenge - 2):
        folge = folgewoerter_2(woerter, wort1, wort2)
        if len(folge) == 0:
            break
        naechstes = folge[random.randint(0, len(folge) - 1)]
        text = text + " " + naechstes
        wort1 = wort2
        wort2 = naechstes
    return text

print(folgewoerter_2(woerter, "mit", "dem"))
print(generiere_text_trigramm(woerter, "der", "hund", 10))
print(generiere_text_trigramm(woerter, "der", "ball", 10))
['ball']
der hund läuft zur katze die katze rennt weg der
der ballDie zweite Zeile ist ein Beispiel. Nach jedem Schritt rückt das Wortpaar um eins weiter: Das bisherige zweite Wort wird das erste, das neue Wort wird das zweite.
Vergleich: Die Trigramm-Texte wirken sinnvoller, weil jedes Stück aus drei Wörtern genau so im Korpus vorkommt. Kombinationen wie „spielt mit dem baum“ sind nicht mehr möglich. Dafür sind die Texte weniger abwechslungsreich: Nur nach „der hund“, „hund läuft“ und „die katze“ gibt es überhaupt eine Auswahl, sonst wird der Korpus einfach abgeschrieben.
Abbruch: Die Generierung bricht ab, sobald ein Wortpaar keine Fortsetzung hat. Ein Wortpaar ist viel seltener als ein einzelnes Wort. Das Startpaar „der ball“ kommt im Korpus nie vor, obwohl „der“ und „ball“ einzeln vorkommen – deshalb gibt es sofort keine Fortsetzung. Beim Bigramm-Modell hätte „ball“ allein ein Folgewort gehabt. In unserem kleinen Korpus bricht ein Text, der mit einem vorhandenen Paar beginnt, nur am Korpusende („ist müde“) ab. Je kleiner der Korpus und je länger die n-Gramme, desto häufiger stößt das Modell aber auf Kontexte, die es nicht kennt.
4.4.6Die Trainingsdaten bestimmen den Text
Ein n-Gramm-Modell kann nur Wörter und Wortfolgen erzeugen, die in seinem Korpus vorkommen. Was das bedeutet, untersuchst du im nächsten Auftrag.
Ersetze im Programm den Korpus durch einen inhaltlich ganz anderen Text, zum Beispiel:
korpus = """
heute scheint die sonne heute regnet es stark
morgen scheint die sonne morgen ist es bewölkt
heute ist es bewölkt heute regnet es leicht
"""
Zerlege ihn mit split() und erzeuge mehrmals Texte mit
generiere_text(woerter, "heute", 8, "random").
- Wie stark unterscheidet sich der erzeugte Text vom Hund-Katze-Beispiel?
- Was bedeutet das für die Aussage „Ein Sprachmodell erzeugt objektiven, neutralen Text“?
- Freiwillig: Beobachte dasselbe mit SoekiaGPT, indem du dort zwischen zwei unterschiedlichen Textsammlungen wechselst und denselben Satzanfang eingibst. Das Prinzip ist identisch.
Meine Antworten:
Lösung vergleichen
wetter = """
heute scheint die sonne heute regnet es stark
morgen scheint die sonne morgen ist es bewölkt
heute ist es bewölkt heute regnet es leicht
"""
woerter_wetter = wetter.split()
print(generiere_text(woerter_wetter, "heute", 8, "random"))
print(generiere_text(woerter_wetter, "heute", 8, "random"))
heute regnet es bewölkt heute ist es stark
heute scheint die sonne morgen scheint die sonne(Beispielausgabe.)
- Der Text hat mit dem Hund-Katze-Beispiel überhaupt nichts mehr gemein. Es kommen nur noch Wörter aus dem Wetter-Korpus vor: heute, morgen, sonne, regnet, bewölkt … Kein Hund, keine Katze. Das Programm ist dasselbe, nur die Trainingsdaten sind andere. Auch Kombinationen wie „regnet es bewölkt“ entstehen nur, weil „es bewölkt“ und „regnet es“ im Korpus vorkommen.
- Ein Sprachmodell gibt wieder, was in seinen Trainingsdaten steht – mit allen Themen, Formulierungen, Einseitigkeiten und Fehlern dieser Texte. Kommt in den Trainingsdaten eine bestimmte Sichtweise häufiger vor, wird sie auch häufiger erzeugt. Der Text ist also nicht automatisch objektiv oder neutral. Wer ein Sprachmodell beurteilen will, muss fragen: Mit welchen Daten wurde es trainiert?
- In SoekiaGPT liefert derselbe Satzanfang mit einer anderen Textsammlung ganz andere Fortsetzungen.
4.4.7Weitere Übungen
Hier kannst du das Gelernte weiter üben. Die Punkte im Titel zeigen, wie schwer eine Aufgabe ist: ●○○ leicht, ●●○ mittel, ●●● knifflig. Fang mit den leichten an.
Mehrere Aufträge verwenden diesen Ausschnitt aus der Bigramm-Tabelle eines Korpus mit Chatnachrichten:
| Kontext | mögliche Folgewörter (Anzahl) |
|---|---|
| ich | gehe (5), bin (3), habe (2) |
| gehe | heute (4), nach (1) |
| heute | ins (3), nicht (2) |
| ins | kino (4), bett (3) |
| kino | und (2) |
| und | ich (3), dann (1) |
| bin | müde (3), heute (1) |
| müde | und (2) |
Ergänze die Lücken. Verwende diese Wörter: angehängt · endet · Folgewörter · nächste · Startwort · Tabelle.
Bei der Textgenerierung gibt man ein ____________ vor. Das Modell schaut in der n-Gramm-____________ nach, welche ____________ auf das letzte Wort folgen können. Eines davon wird ausgewählt und an den Text ____________. Es ist jetzt das neue letzte Wort. So wird immer wieder das ____________ Wort vorhergesagt. Hat das letzte Wort keine Folgewörter, ____________ der Text.
Lösung vergleichen
Bei der Textgenerierung gibt man ein Startwort vor. Das Modell schaut in der n-Gramm-Tabelle nach, welche Folgewörter auf das letzte Wort folgen können. Eines davon wird ausgewählt und an den Text angehängt. Es ist jetzt das neue letzte Wort. So wird immer wieder das nächste Wort vorhergesagt. Hat das letzte Wort keine Folgewörter, endet der Text.
Ordne jeder Beschreibung die passende Sampling-Strategie zu: greedy, random oder top-k.
| Nr. | Beschreibung | Strategie |
|---|---|---|
| 1 | Es wird immer das Folgewort mit der höchsten Wahrscheinlichkeit gewählt. | |
| 2 | Es wird unter allen Folgewörtern gelost. Häufige Folgewörter haben eine größere Chance. | |
| 3 | Nur die drei wahrscheinlichsten Folgewörter kommen in Frage. Unter ihnen wird gewichtet gelost. | |
| 4 | Mit demselben Startwort entsteht jedes Mal derselbe Text. | |
| 5 | Jedes Folgewort, das im Korpus vorkam, kann gewählt werden – auch das seltenste. | |
| 6 | Diese Strategie ist ein Kompromiss zwischen Vorhersagbarkeit und Abwechslung. |
Lösung vergleichen
| Nr. | Strategie | Begründung |
|---|---|---|
| 1 | greedy | „gierig“: immer das wahrscheinlichste Wort |
| 2 | random | gewichtet nach Wahrscheinlichkeit gelost |
| 3 | top-k | hier mit |
| 4 | greedy | Greedy ist deterministisch, es gibt keinen Zufall. |
| 5 | random | Bei top-k fallen seltene Wörter heraus, bei greedy kommen sie nie dran. |
| 6 | top-k | Seltene Wörter werden gestrichen (vorhersagbarer), unter den übrigen wird gelost (abwechslungsreicher). |
Verwende den Tabellenausschnitt vom Anfang dieser Übungen.
- Erzeuge mit greedy einen Text aus 8 Wörtern, der mit „ich“ beginnt.
- Beschreibe, was dir an dem Text auffällt.
- Erkläre, warum greedy bei jedem Start genau denselben Text liefert.
Mein Text und meine Antworten:
Lösung vergleichen
ich gehe heute ins kino und ich gehe
ich → gehe (5 ist die größte Anzahl) → heute (4) → ins (3) → kino (4) → und (2) → ich (3) → gehe (5).
Nach „und“ folgt wieder „ich“, und ab da wiederholt sich alles: Der Text läuft im Kreis. Wörter wie „bin“, „habe“ oder „müde“ kommen nie vor.
Greedy wählt in jedem Schritt das Folgewort mit der höchsten Wahrscheinlichkeit. Es gibt keinen Zufall. Gleiches Startwort und gleiche Tabelle ergeben deshalb immer denselben Text (deterministisch).
In einem Korpus folgen auf „heute“ diese Wörter: „abend“ (6-mal), „nicht“ (3-mal), „schon“ (2-mal) und „mal“ (1-mal).
- Berechne die Wahrscheinlichkeiten der Folgewörter bei random.
- Berechne sie bei top-2 und bei top-3.
- Welches Wort wählt greedy?
Runde auf ganze Prozent.
| Folgewort | Anzahl | random | top-2 | top-3 |
|---|---|---|---|---|
| abend | 6 | |||
| nicht | 3 | |||
| schon | 2 | |||
| mal | 1 |
Lösung vergleichen
| Folgewort | Anzahl | random | top-2 | top-3 |
|---|---|---|---|---|
| abend | 6 | |||
| nicht | 3 | |||
| schon | 2 | gestrichen | ||
| mal | 1 | gestrichen | gestrichen |
Bei random ist der Nenner . Bei top-2 bleiben nur „abend“ und „nicht“, der Nenner ist . Bei top-3 ist er . Kontrolle: In jeder Spalte ergeben die Prozente zusammen 100 %.
Zu 3: Greedy wählt immer „abend“.
Häufiger Fehler: Bei top-k weiter durch 12 teilen. Die gestrichenen Wörter zählen nicht mehr mit, deshalb ändert sich der Nenner.
Mit random wird aus dem Tabellenausschnitt vom Anfang dieser Übungen ein Text erzeugt, der mit „ich“ beginnt. Für jeden Schritt wird eine Zufallszahl gezogen. Jedes Folgewort bekommt so viele Lose, wie es vorkommt, durchnummeriert in der Reihenfolge der Tabelle. Bei „ich“ heißt das: Lose 1 bis 5 sind „gehe“, 6 bis 8 „bin“, 9 und 10 „habe“.
Die Zufallszahlen sind der Reihe nach: 7, 4, 2, 1, 2, 4.
- Bestimme den erzeugten Text. Notiere bei jedem Schritt, welche Lose zu welchem Wort gehören.
- Kann greedy diesen Text erzeugen? Begründe.
- Mit welcher Wahrscheinlichkeit wählt random nach „ich“ das Wort „bin“?
Meine Schritte und Antworten:
Lösung vergleichen
Zu 1:
| Kontext | Lose | Zufallszahl | gewählt |
|---|---|---|---|
| ich | 1–5 gehe, 6–8 bin, 9–10 habe | 7 | bin |
| bin | 1–3 müde, 4 heute | 4 | heute |
| heute | 1–3 ins, 4–5 nicht | 2 | ins |
| ins | 1–4 kino, 5–7 bett | 1 | kino |
| kino | 1–2 und | 2 | und |
| und | 1–3 ich, 4 dann | 4 | dann |
Der Text lautet: ich bin heute ins kino und dann
Zu 2: Nein. Greedy wählt nach „ich“ immer „gehe“ (5 von 10), nie „bin“. Auch nach „bin“ würde greedy „müde“ wählen und nach „und“ „ich“.
Zu 3: .
Achte darauf, dass die Anzahl der Lose von Kontext zu Kontext verschieden ist: Bei „ich“ sind es 10, bei „bin“ nur 4.
Ein Bigramm-Modell wurde mit diesem Korpus trainiert:
lisa fährt mit dem bus tim fährt mit dem rad lisa geht zu fuß
Entscheide für jeden Text, ob das Modell ihn mit random erzeugen kann. Wenn nicht, nenne ein Wortpaar im Text, das im Korpus nicht vorkommt.
| Text | möglich? | fehlendes Wortpaar |
|---|---|---|
| tim fährt mit dem bus | ||
| lisa fährt mit dem auto | ||
| dem rad lisa geht zu fuß | ||
| lisa geht mit dem bus |
Welcher der möglichen Texte kommt so nicht im Korpus vor?
Antwort zur letzten Frage:
Lösung vergleichen
| Text | möglich? | fehlendes Wortpaar |
|---|---|---|
| tim fährt mit dem bus | ja | – |
| lisa fährt mit dem auto | nein | dem auto („auto“ kommt im Korpus gar nicht vor) |
| dem rad lisa geht zu fuß | ja | – |
| lisa geht mit dem bus | nein | geht mit |
Ein Text ist genau dann möglich, wenn jedes Wortpaar darin im Korpus vorkommt. „dem rad lisa geht zu fuß“ steht genau so im Korpus. „tim fährt mit dem bus“ dagegen nicht: Im Korpus fährt Tim mit dem Rad. Das Modell kann den Satz trotzdem bilden, weil es nach „dem“ nur auf „dem“ schaut und zwischen „bus“ und „rad“ lost.
Gegeben ist der Korpus:
ich trinke einen kakao ich esse einen apfel ich trinke einen tee
- Bestimme im Bigramm-Modell die Folgewörter von „einen“ mit ihren Wahrscheinlichkeiten.
- Bestimme im Trigramm-Modell die Folgewörter der Kontexte „trinke einen“ und „esse einen“ mit ihren Wahrscheinlichkeiten.
- Kann das Bigramm-Modell den Text „ich trinke einen apfel“ erzeugen? Und das Trigramm-Modell?
- Erkläre an diesem Beispiel, warum größere n kohärentere, aber weniger variantenreiche Texte erzeugen.
Meine Antworten:
Lösung vergleichen
- Nach „einen“ folgen „kakao“, „apfel“ und „tee“ je einmal, also je .
- Im Trigramm-Modell:
| Kontext | Folgewort | Anzahl | Wahrscheinlichkeit |
|---|---|---|---|
| trinke einen | kakao | 1 | |
| trinke einen | tee | 1 | |
| esse einen | apfel | 1 |
- Das Bigramm-Modell kann es: „ich trinke“, „trinke einen“ und „einen apfel“ kommen alle im Korpus vor. Das Trigramm-Modell kann es nicht: Nach „trinke einen“ folgt nie „apfel“.
- Das Trigramm-Modell schaut auf zwei Wörter. Es „weiß“ dadurch, ob getrunken oder gegessen wird, und erzeugt keine unsinnigen Kombinationen mehr: Der Text wird kohärenter. Dafür gibt es weniger Auswahl: Nach „einen“ hat das Bigramm-Modell drei Möglichkeiten, nach „esse einen“ hat das Trigramm-Modell nur eine. Der Text wird weniger variantenreich, weil der längere Kontext spezifischer ist und seltener im Korpus vorkommt.
Zwei Bigramm-Modelle wurden mit verschiedenen Korpora trainiert:
- Verein: „wir trainieren hart wir trainieren lange wir gewinnen das spiel wir trainieren hart“
- Schule: „wir lernen vokabeln wir lernen mathe wir schreiben eine arbeit wir lernen vokabeln“
- Bestimme für beide Modelle den Text, den greedy ab „wir“ mit 5 Wörtern erzeugt.
- Erkläre, warum dasselbe Verfahren mit demselben Startwort ganz verschiedene Texte erzeugt.
- An den Schul-Korpus wird mehrmals der Satz „wir schreiben eine arbeit“ angehängt. Wie oft mindestens, damit greedy nach „wir“ das Wort „schreiben“ wählt? Bei Gleichstand wählt greedy das Folgewort, das im Korpus zuerst vorkommt.
- Prüfe deine Antworten mit der Funktion
generiere_textaus diesem Abschnitt.
Meine Antworten zu 1 bis 3:
Lösung vergleichen
- Verein: „wir“ → trainieren (3 von 4) → hart (2 von 3) → wir → trainieren: wir trainieren hart wir trainieren. Schule: „wir“ → lernen (3 von 4) → vokabeln (2 von 3) → wir → lernen: wir lernen vokabeln wir lernen.
- Das Verfahren ist gleich, aber die Tabellen sind verschieden, weil sie aus verschiedenen Trainingsdaten stammen. Ein n-Gramm-Modell kann nur Wörter und Wortfolgen erzeugen, die in seinem Korpus vorkommen. Was dort häufig ist, wird auch häufig erzeugt.
- Im Schul-Korpus folgt auf „wir“ dreimal „lernen“ und einmal „schreiben“. Damit greedy „schreiben“ wählt, muss „wir schreiben“ öfter vorkommen als „wir lernen“, also mindestens 4-mal. Der Satz muss also mindestens 3-mal angehängt werden. Bei 2-mal stünde es 3 zu 3, und „lernen“ gewinnt, weil es im Korpus zuerst vorkommt.
- Kontrolle:
verein = "wir trainieren hart wir trainieren lange wir gewinnen "
verein = verein + "das spiel wir trainieren hart"
schule = "wir lernen vokabeln wir lernen mathe wir schreiben "
schule = schule + "eine arbeit wir lernen vokabeln"
print(generiere_text(verein.split(), "wir", 5, "greedy"))
print(generiere_text(schule.split(), "wir", 5, "greedy"))

satz = " wir schreiben eine arbeit"
mehr = schule + satz + satz
print(generiere_text(mehr.split(), "wir", 5, "greedy"))
mehr = mehr + satz
print(generiere_text(mehr.split(), "wir", 5, "greedy"))
wir trainieren hart wir trainieren
wir lernen vokabeln wir lernen
wir lernen vokabeln wir lernen
wir schreiben eine arbeit wirMit zwei angehängten Sätzen (dritte Zeile) gewinnt noch „lernen“, erst mit dem dritten (vierte Zeile) „schreiben“. Die angehängten Sätze beginnen mit einem Leerzeichen, damit die Wörter nicht zusammenkleben.
4.4.8Das Wichtigste in Kürze
- Bei der Textgenerierung (next word prediction) wird ab einem Startwort immer wieder das nächste Wort bestimmt und angehängt. Hat ein Wort keine Folgewörter, endet der Text.
- Die Sampling-Strategie legt fest, wie das Folgewort
ausgewählt wird:
- greedy: immer das wahrscheinlichste → deterministisch, aber eintönig, oft Wiederholungen,
- random: gewichtet zufällig (Lostrommel) → abwechslungsreich, manchmal unsinnig,
- top-k: gewichtet zufällig unter den wahrscheinlichsten → Kompromiss.
- Bei top-k werden die Wahrscheinlichkeiten der übrigen Wörter neu berechnet (z. B. statt ).
- Längere n-Gramme liefern kohärentere, aber weniger variantenreiche Texte. Lange Kontexte kommen im Korpus seltener vor.
- Der erzeugte Text hängt vollständig von den Trainingsdaten ab. Ein Sprachmodell ist deshalb nicht automatisch neutral.
4.5Halluzinationen, moderne KI und die Arbeitswelt DS34
Diesen Abschnitt als PDF (S. 59–72)
Das Jupyter-Notebook aus dem Unterricht: DS34_Halluzination_LLMs_Berufsorientierung.ipynb. Herunterladen und in VS Code oder Jupyter öffnen.
Ein Sprachmodell schreibt einen Satz, der flüssig klingt und grammatisch einwandfrei ist – und trotzdem ist er falsch. Fachleute nennen das Halluzination. Das passiert nicht nur kleinen Modellen, sondern auch großen Chatbots. Mit deinem Wissen über n-Gramm-Modelle kannst du jetzt genau erklären, warum das passiert. Danach vergleichst du das einfache n-Gramm-Modell mit modernen Sprachmodellen und überlegst, was das für deinen Umgang mit KI bedeutet. Zum Schluss blickst du in die Arbeitswelt: Wie verändert generative KI Berufe, und welche neuen entstehen?
Nach diesem Abschnitt kannst du
- erklären, was eine Halluzination ist und wie sie bei n-Gramm-Modellen entsteht,
- an einem Beispiel zeigen, warum ein flüssig klingender Satz inhaltlich falsch sein kann,
- Unterschiede zwischen n-Gramm-Modellen und modernen LLMs in Sprachqualität, Korrektheit, Kontextberücksichtigung und Vielseitigkeit beschreiben,
- begründen, warum man Aussagen von KI-Systemen selbst überprüfen muss,
- Auswirkungen generativer KI auf ein Berufsfeld recherchieren und darstellen.
4.5.1Ein Satz, der nur richtig klingt
Wir trainieren ein Bigramm-Modell mit einem sehr kleinen Korpus aus drei richtigen Sätzen:
berlin ist die hauptstadt von deutschland
paris ist die hauptstadt von frankreich
rom ist die hauptstadt von italien
Die Bigramm-Tabelle ist schnell aufgestellt. Auf „berlin“, „paris“ und „rom“ folgt jeweils „ist“, darauf „die“, dann „hauptstadt“ und dann „von“. Erst nach „von“ gibt es eine Auswahl:
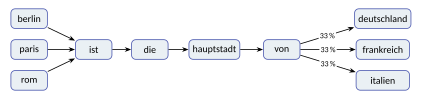
Jetzt lassen wir das Modell mit dem Startwort „paris“ einen Satz aus sechs Wörtern schreiben, und zwar mit greedy. Bis „von“ gibt es keine Wahl: „paris ist die hauptstadt von“. Nach „von“ haben alle drei Länder dieselbe Wahrscheinlichkeit. Greedy nimmt bei Gleichstand das Wort, das im Korpus zuerst vorkommt, also „deutschland“. Das Ergebnis:
paris ist die hauptstadt von deutschland
Der Satz ist grammatisch perfekt. Jedes Wortpaar darin kommt genau so im Trainingstext vor. Und trotzdem ist die Aussage falsch. Mit random wäre es nicht besser: Dann ist der Satz in zwei von drei Fällen falsch, egal mit welcher Stadt er beginnt.
Woran liegt das? Wenn das Modell das Wort nach „von“ auswählt, schaut es nur auf „von“. Dass am Anfang „paris“ stand, hat es längst „vergessen“ – es hat es nie beachtet. Das Modell weiß auch nicht, was eine Hauptstadt ist oder was die Wörter bedeuten. Es reiht Wörter nach Wahrscheinlichkeit aneinander. Ob der Satz wahr ist, spielt dabei keine Rolle.
Eine Halluzination ist ein von einem Sprachmodell erzeugter Text, der sprachlich plausibel klingt, aber inhaltlich falsch oder unsinnig ist.
- Halluzination bezeichnet das Phänomen, dass ein Sprachmodell Text erzeugt, der grammatikalisch bzw. statistisch plausibel, aber inhaltlich falsch oder unsinnig ist.
- Bei n-Gramm-Modellen entsteht Halluzination, weil das Modell keinerlei „Verständnis“ der Bedeutung hat. Es reiht Wörter nur nach statistischer Wahrscheinlichkeit aneinander, unabhängig davon, ob der entstehende Satz sachlich korrekt ist.
Das Wort Halluzination kommt eigentlich aus der Medizin. Dort bezeichnet es Wahrnehmungen von Dingen, die gar nicht da sind. Bei Sprachmodellen ist der Begriff ein Bild: Das Modell „erfindet“ etwas, ohne es zu merken. In Wirklichkeit merkt es gar nichts – es rechnet nur.
So erklärst du eine Halluzination in Fachsprache:
- „Das Modell hat sich vertan.“ → „Das Modell hat eine Halluzination erzeugt: Der Satz ist grammatisch korrekt, aber inhaltlich falsch.“
- „Es hat Paris vergessen.“ → „Das Bigramm-Modell berücksichtigt nur das letzte Wort als Kontext. Deshalb wählt es das Folgewort von ‚von‘ unabhängig vom Satzanfang aus.“
Verwende das Bigramm-Modell zum Hauptstadt-Korpus.
- Das Modell erzeugt mit random einen Satz aus sechs Wörtern, der mit „rom“ beginnt. Wie groß ist die Wahrscheinlichkeit, dass der Satz inhaltlich richtig ist? Wie groß ist sie, dass er falsch ist?
- Würde ein Trigramm-Modell (Kontext aus zwei Wörtern) das Problem lösen? Begründe.
- Wie lang müsste der Kontext mindestens sein, damit das Modell immer das richtige Land wählt? Was ist dann der Nachteil?
Meine Antworten:
Lösung vergleichen
- Bis „von“ ist der Satz festgelegt: „rom ist die hauptstadt von“. Nach „von“ wird eines von drei gleich wahrscheinlichen Ländern ausgelost. Richtig ist der Satz nur mit „italien“: . Falsch ist er mit „deutschland“ oder „frankreich“: .
- Nein. Der Kontext wäre dann „hauptstadt von“. Auch nach „hauptstadt von“ folgen im Korpus alle drei Länder je einmal. Die Stadt am Satzanfang liegt immer noch außerhalb des Kontexts.
- Der Kontext müsste die Stadt enthalten, also die fünf Wörter „rom ist die hauptstadt von“ – das wäre ein 6-Gramm-Modell. Dann folgt nach jedem Kontext nur noch ein einziges Wort. Das Modell schreibt den Korpus aber nur noch wörtlich ab. Es kann keinen einzigen neuen Satz mehr bilden, und zu jedem Startkontext, der nicht genau so im Korpus steht, findet es gar keine Fortsetzung.
4.5.2Halluzinationen im Hund-Katze-Modell
Auch mit dem Hund-Katze-Korpus aus den letzten Abschnitten entstehen
leicht seltsame Sätze. Das folgende Programm erzeugt mit random fünf
Texte, die mit „die“ beginnen. Es enthält nur die Funktionen, die dafür
nötig sind. Die Funktion generiere_text_random ist eine
kürzere Fassung von generiere_text aus dem Abschnitt über
Textgenerierung, die immer mit random auswählt.
import random

def folgewoerter(woerter, wort):
    folge = []
    for i in range(len(woerter) - 1):
        if woerter[i] == wort:
            folge.append(woerter[i + 1])
    return folge

def generiere_text_random(woerter, startwort, laenge):
    text = startwort
    aktuelles_wort = startwort
    for schritt in range(laenge - 1):
        folge = folgewoerter(woerter, aktuelles_wort)
        if len(folge) == 0:
            break
        aktuelles_wort = folge[random.randint(0, len(folge) - 1)]
        text = text + " " + aktuelles_wort
    return text

korpus = """
der hund läuft im park der hund spielt mit dem ball
die katze sitzt auf dem baum die katze beobachtet den hund
der hund bellt laut der hund läuft zur katze
die katze springt vom baum die katze rennt weg
der hund läuft ihr hinterher der hund ist müde
"""
woerter = korpus.split()
for nummer in range(5):
    print(generiere_text_random(woerter, "die", 8))
die katze sitzt auf dem ball die katze
die katze beobachtet den hund läuft zur katze
die katze springt vom baum die katze rennt
die katze rennt weg der hund ist müde
die katze die katze sitzt auf dem baumDie Ausgabe ist ein Beispiel. Bei jedem Start entstehen andere Texte.
- Zeilen 3–8:
folgewoertersammelt alle Folgewörter eines Wortes, mit Wiederholungen. Diese Liste ist die Lostrommel. - Zeilen 10–19: In jedem Schritt wird ein Los aus der Lostrommel des aktuellen Wortes gezogen und angehängt. Ohne Folgewörter endet der Text.
- Zeilen 29–30: Fünf Texte mit je höchstens acht Wörtern werden erzeugt.
Schau dir die erste Zeile an: „die katze sitzt auf dem ball“. Im Korpus sitzt die Katze auf dem Baum, und mit dem Ball spielt der Hund. Das Modell hat nach „dem“ zwischen „ball“ und „baum“ gelost – beide Wortpaare sind im Korpus richtig, der Satz insgesamt ist eine Erfindung. Auch „den hund läuft zur katze“ ist grammatisch holprig, weil nach „hund“ nicht beachtet wird, dass davor „den“ stand.
Führe das Programm mehrmals aus. Suche einen erzeugten Satz heraus, der grammatikalisch plausibel, aber inhaltlich seltsam oder unsinnig ist. Erkläre in eigenen Worten, warum genau dieser Fehler entsteht. Beziehe dich dabei auf die Funktionsweise des n-Gramm-Modells.
Mein Beispielsatz und meine Erklärung:
Lösung vergleichen
Beispiel: „die katze sitzt auf dem ball die katze“
Erklärung: Im Korpus steht „die katze sitzt auf dem baum“ und „der hund spielt mit dem ball“. Das Modell betrachtet bei jedem Schritt nur das letzte Wort. Nach „dem“ folgt im Korpus je einmal „ball“ und „baum“, also wird mit je 50 % gelost. Dass der Satz von einer Katze auf einem Baum handelte, weiß das Modell nicht, denn „katze“ und „sitzt“ liegen außerhalb seines Kontexts. Jedes einzelne Wortpaar kommt im Trainingstext vor, deshalb klingt der Satz plausibel. Die Kombination ist aber nirgends belegt – eine Halluzination.
Weitere mögliche Beispiele: „der hund spielt mit dem baum“ (gleiche Ursache bei „dem“), „die katze beobachtet den hund läuft zur katze“ (nach „hund“ wird nicht beachtet, dass „den hund“ ein Satzteil im vierten Fall war), „der hund läuft zur katze rennt weg“.
Worauf es ankommt: Ursache benennen (nur das letzte Wort als Kontext, Auswahl nach Wahrscheinlichkeit) und erklären, dass das Modell die Bedeutung nicht kennt.
Wenn deine SoekiaGPT-Version eigene Texte erlaubt, lege eine eigene kleine Textsammlung an, zum Beispiel mit drei oder vier kurzen Steckbriefen von Fantasietieren, die ähnlich aufgebaut sind („der glitzerfuchs lebt im wald und frisst beeren …“). Lass dann Texte erzeugen, die mit dem Namen eines Tieres beginnen. Werden Eigenschaften verschiedener Tiere vermischt? Schau dir in der n-Gramm-Anzeige auch längere n-Gramme an: Welche Wortfolgen stammen aus nur einem einzigen Steckbrief?
4.5.3n-Gramm-Modelle und moderne LLMs
Moderne Chatbots beruhen auf Large Language Models (LLMs). Sie schätzen ebenfalls Wahrscheinlichkeiten für die Fortsetzung eines Textes, sind aber in vieler Hinsicht viel leistungsfähiger als unser n-Gramm-Modell. Ein LLM wurde mit unvorstellbar viel mehr Text trainiert und betrachtet nicht nur ein oder zwei Wörter, sondern sehr lange Textabschnitte als Kontext. Dadurch „vergisst“ es den Satzanfang nicht so schnell wie unser Modell.
Trotzdem bleibt das Grundprinzip gleich: Ein LLM erzeugt Text, der wahrscheinlich klingt. Es schlägt nicht in einer geprüften Faktensammlung nach. Wenn eine Information in den Trainingsdaten selten, widersprüchlich oder gar nicht vorkommt, erzeugt es trotzdem eine flüssige Antwort. Bekannte Beispiele sind erfundene Quellenangaben mit Büchern oder Artikeln, die es nicht gibt, falsche Jahreszahlen oder erfundene Zitate.
Moderne LLMs unterscheiden sich von einfachen n-Gramm-Modellen u. a. in:
- Sprachqualität: LLMs erzeugen deutlich flüssigeren, grammatikalisch korrekteren Text.
- Kontextberücksichtigung: LLMs können sehr viel längere Kontexte einbeziehen (nicht nur 1–2 vorherige Wörter).
- Korrektheit: LLMs erzeugen häufig zuverlässigere Antworten, können aber weiterhin halluzinieren. Das n-Gramm-Modell dient hierfür als vereinfachte Analogie: Auch LLMs erzeugen Text Wort für Wort nach Wahrscheinlichkeiten und prüfen ihn nicht an Fakten. Die Ursachen bei modernen LLMs sind aber wesentlich komplexer und nicht mit dem einfachen Modell gleichzusetzen.
- Vielseitigkeit: LLMs können unterschiedlichste Aufgaben bewältigen (Übersetzen, Zusammenfassen, Programmieren …), während ein einfaches n-Gramm-Modell nur Text im Stil seines Trainingskorpus fortsetzt.
Stelle n-Gramm-Modelle und moderne LLMs in einer Tabelle gegenüber. Beschreibe für jedes Kriterium in eigenen Worten, was du beobachtet hast, und nenne – wo möglich – ein Beispiel aus diesem Kapitel.
| Kriterium | n-Gramm-Modell | modernes LLM |
|---|---|---|
| Sprachqualität | ||
| Korrektheit | ||
| Kontextberücksichtigung | ||
| Vielseitigkeit |
Lösung vergleichen
| Kriterium | n-Gramm-Modell | modernes LLM |
|---|---|---|
| Sprachqualität | oft holprig, Sätze brechen ab oder laufen ineinander („den hund läuft zur katze“) | flüssig, grammatisch meist korrekt, passender Stil |
| Korrektheit | Inhalt ist Zufall: Jedes Wortpaar stammt aus dem Korpus, die Kombination kann falsch sein („paris ist die hauptstadt von deutschland“) | meist zuverlässiger, kann aber weiterhin halluzinieren; das n-Gramm-Modell erklärt das nur vereinfacht |
| Kontextberücksichtigung | nur 1–2 vorherige Wörter, der Satzanfang wird „vergessen“ | sehr lange Kontexte, z. B. ganze Gesprächsverläufe oder lange Texte |
| Vielseitigkeit | setzt nur Text im Stil seines Korpus fort (Hund-Katze, Wetter …) | kann übersetzen, zusammenfassen, erklären, programmieren und vieles mehr |
Worauf es ankommt: In jeder Zeile sollte deutlich werden, dass LLMs besser sind – aber bei der Korrektheit nicht grundsätzlich anders: Auch ein LLM kann flüssig klingende, falsche Aussagen erzeugen.
4.5.4Fakten selbst prüfen
Weil auch große Sprachmodelle halluzinieren können, gilt: Was ein KI-System schreibt, ist ein Vorschlag, keine geprüfte Tatsache. Gerade weil die Texte so überzeugend klingen, fallen Fehler leicht nicht auf. Das ist auch für unsere Gesellschaft wichtig: Falschinformationen (Desinformation) verbreiten sich schnell, und wer Aussagen nicht prüft, kann leichter getäuscht oder manipuliert werden. In einer Demokratie ist es wichtig, dass sich Menschen ihre Meinung auf Grundlage zutreffender Informationen bilden.
So gehst du vor, wenn du eine Aussage eines KI-Systems verwenden willst:
- Unabhängig prüfen: Suche die Aussage in mindestens einer seriösen, unabhängigen Quelle (z. B. Lehrbuch, Fachlexikon, Website einer Behörde oder Hochschule, Qualitätszeitung).
- Quellen nachschlagen: Nennt das System Quellen, prüfe, ob es sie wirklich gibt und ob dort tatsächlich das steht, was behauptet wird.
- Besonders vorsichtig sein bei Zahlen, Jahreszahlen, Namen, Zitaten und Literaturangaben. Hier entstehen Halluzinationen besonders leicht.
- Aktualität beachten: Ein Sprachmodell selbst kennt nur, was in seinen Trainingsdaten stand. Über neuere Ereignisse weiß ein Chatbot nur etwas, wenn er zusätzlich im Internet sucht – und auch dann können Fehler entstehen.
KI-Systeme erzeugen Texte nach Wahrscheinlichkeit, nicht nach Wahrheit. Wichtige Aussagen muss man deshalb selbst mit seriösen Quellen überprüfen – das schützt vor Irrtümern, Desinformation und Manipulation.
Deine Mitschülerin sagt: „Was der Chatbot schreibt, stimmt bestimmt. Er klingt doch total sicher und hat sogar Quellen angegeben.“
Nimm Stellung zu dieser Aussage. Verwende dabei, was du über Halluzinationen weißt.
Meine Stellungnahme:
Lösung vergleichen
Mögliche Stellungnahme: Die Aussage ist nicht haltbar. Ein Chatbot erzeugt Text nach Wahrscheinlichkeit: Er wählt Wörter, die gut zueinander passen, und prüft nicht, ob die Aussage wahr ist. Deshalb klingt er auch dann sicher, wenn er sich irrt – ein sicherer Ton ist kein Beleg für Richtigkeit. Das gilt auch für Quellenangaben: Auch sie werden als wahrscheinlich klingender Text erzeugt und können erfunden sein. Man sollte die genannten Quellen deshalb selbst aufrufen und wichtige Aussagen in unabhängigen, seriösen Quellen nachprüfen.
Worauf es ankommt: Begründung mit der Funktionsweise (Wahrscheinlichkeit statt Wissen) und ein konkreter Rat, wie man prüft.
4.5.5Berufliche Orientierung: Generative KI in der Arbeitswelt
Sprachmodelle und andere generative KI-Systeme (Systeme, die Texte, Bilder, Musik oder Programmcode erzeugen) werden inzwischen in vielen Berufen eingesetzt. Manche Tätigkeiten werden dadurch schneller oder einfacher, manche fallen weg, und es entstehen neue Aufgaben – zum Beispiel das geschickte Formulieren von Anweisungen an eine KI, das Prompt Engineering, oder das Prüfen und Überarbeiten von KI-Ergebnissen.
Wie stark ein Beruf betroffen ist, lässt sich nicht pauschal sagen. Deshalb recherchierst du selbst, am besten zu zweit oder zu dritt.
Recherchiert die Auswirkungen generativer KI-Systeme auf ein Berufsfeld eurer Wahl, zum Beispiel:
- Journalismus und Erstellen von Inhalten für Websites und soziale Medien,
- Softwareentwicklung,
- Grafikdesign und Illustration,
- Kundenservice und Support,
- Übersetzen und Dolmetschen.
Leitfragen für eure Recherche:
- Welche Tätigkeiten dieses Berufsfeldes werden bereits heute durch generative KI unterstützt oder verändert?
- Entstehen durch generative KI neue Aufgaben oder sogar neue Berufsbilder in diesem Bereich (z. B. Prompt Engineering)?
- Welche Tätigkeiten lassen sich aus heutiger Sicht nicht oder nur schwer durch KI ersetzen – und warum?
- Wie bewertet ihr diese Entwicklung? Welche Chancen und welche Risiken seht ihr?
- Findet (falls möglich) eine reale Person mit Bezug zu diesem Berufsfeld und recherchiert ihre Berufsbiografie (Ausbildung, erste Stelle, heutige Tätigkeit), z. B. über ein Interview, eine Unternehmenswebsite oder ein Karriereportal.
Haltet eure Ergebnisse in Stichpunkten in der Ergebnisvorlage unten fest und bereitet einen kurzen mündlichen Beitrag von etwa einer Minute vor.
Seriöse Quellen für die Recherche sind zum Beispiel: das Berufsinformationsportal BERUFENET und die Seite planet-beruf.de der Bundesagentur für Arbeit, das Berufsinformationszentrum (BIZ) der Agentur für Arbeit, Berufsverbände und Kammern (z. B. IHK, Handwerkskammer), Hochschulen sowie Berichte und Interviews in Qualitätsmedien.
Achte bei jeder Quelle darauf, wer sie veröffentlicht hat und wann. Die Entwicklung ist schnell, ältere Texte können überholt sein. Übernimm Zahlen (z. B. „Anteil der Jobs, die …“) nur, wenn du die Quelle nennen kannst, und notiere, worauf sich die Zahl bezieht. Wenn du einen Chatbot zur Recherche nutzt, prüfe seine Aussagen wie im Abschnitt Fakten selbst prüfen beschrieben.
| Ergebnisvorlage: Leitfrage | unsere Ergebnisse (Stichpunkte) |
|---|---|
| Berufsfeld | |
| 1. bereits veränderte oder unterstützte Tätigkeiten | |
| 2. neue Aufgaben und Berufsbilder | |
| 3. (noch) nicht ersetzbare Tätigkeiten und warum | |
| 4. Chancen | |
| 4. Risiken | |
| 5. Berufsbiografie einer realen Person | |
| Quellen (Herausgeber, Titel, Datum) |
Notizen für den mündlichen Beitrag:
Lösung vergleichen
Die Ergebnisse hängen vom gewählten Berufsfeld und von den gefundenen Quellen ab. Eine Musterlösung in Stichpunkten für das Berufsfeld Übersetzen und Dolmetschen:
- Veränderte Tätigkeiten: Maschinelle Übersetzungsprogramme liefern in Sekunden einen ersten Entwurf. Übersetzerinnen und Übersetzer überarbeiten zunehmend solche maschinell erzeugten Texte, statt jeden Satz neu zu schreiben. Auch Fachwortlisten und Recherche werden durch KI unterstützt.
- Neue Aufgaben: Prüfen und Verbessern von KI-Übersetzungen (Qualitätssicherung), Anpassen von Texten an Kultur und Zielgruppe, Auswahl und Einrichtung von Übersetzungssystemen, Formulieren guter Anweisungen (Prompts).
- Schwer ersetzbar: Übersetzen von Literatur und Werbung (Wortspiele, Stil, kulturelle Anspielungen), Texte mit rechtlicher Verantwortung (z. B. Verträge, beglaubigte Übersetzungen), Dolmetschen in heiklen Gesprächen (Gericht, Arztpraxis), bei denen Vertrauen, Verantwortung und Fingerspitzengefühl gefragt sind.
- Chancen: schnellere und günstigere Übersetzungen, mehr Menschen können fremdsprachige Texte verstehen, Entlastung bei Routinetexten. Risiken: Preis- und Zeitdruck für Fachleute, unbemerkte Fehler (Halluzinationen, falsche Fachbegriffe), Datenschutz bei vertraulichen Texten, die in Online-Dienste eingegeben werden.
- Berufsbiografie: Hier kann keine Musterlösung stehen, weil ihr eine reale Person recherchiert. Ein gutes Ergebnis nennt die Stationen in zeitlicher Reihenfolge (Ausbildung oder Studium → Berufseinstieg → heutige Tätigkeit) und gibt die Quelle mit Datum an. Was ihr nicht herausfinden könnt, kennzeichnet ihr mit „unbekannt“ – erfindet nichts.
Worauf es ankommt: konkrete Tätigkeiten statt allgemeiner Aussagen („KI ersetzt alles“), eine begründete eigene Bewertung mit Chancen und Risiken, und für jede Information eine nachprüfbare, seriöse Quelle. Zahlen nur mit Quellenangabe.
4.5.6Weitere Übungen
Hier kannst du das Gelernte weiter üben. Die Punkte im Titel zeigen, wie schwer eine Aufgabe ist: ●○○ leicht, ●●○ mittel, ●●● knifflig. Fang mit den leichten an.
Mehrere Aufträge verwenden ein Bigramm-Modell, das mit diesem Korpus aus zwei Steckbriefen trainiert wurde:
lina wohnt in ottweiler und spielt handball tom wohnt in neunkirchen und spielt schach
Das Modell hat die folgenden Sätze erzeugt. Entscheide jeweils, ob der Satz zu den Steckbriefen im Korpus passt oder ob er eine Halluzination ist.
| Nr. | erzeugter Satz | passt / Halluzination |
|---|---|---|
| 1 | lina wohnt in ottweiler und spielt handball | |
| 2 | tom wohnt in ottweiler und spielt schach | |
| 3 | tom wohnt in neunkirchen und spielt schach | |
| 4 | lina wohnt in neunkirchen und spielt handball | |
| 5 | tom wohnt in neunkirchen und spielt handball |
Lösung vergleichen
| Nr. | passt / Halluzination | Grund |
|---|---|---|
| 1 | passt | steht genau so im Korpus |
| 2 | Halluzination | Tom wohnt in Neunkirchen, nicht in Ottweiler. |
| 3 | passt | steht genau so im Korpus |
| 4 | Halluzination | Lina wohnt in Ottweiler. |
| 5 | Halluzination | Tom spielt Schach, nicht Handball. |
Alle fünf Sätze klingen gleich plausibel und sind grammatisch richtig. Gerade deshalb fallen die falschen nicht sofort auf.
Entscheide, ob die Aussage richtig oder falsch ist. Trage „r“ oder „f“ ein. Verbessere die falschen Aussagen unten.
| Nr. | Aussage | r oder f? |
|---|---|---|
| 1 | Eine Halluzination ist ein Text, der plausibel klingt, aber inhaltlich falsch oder unsinnig ist. | |
| 2 | Ein n-Gramm-Modell halluziniert, weil es absichtlich falsche Dinge schreibt. | |
| 3 | Moderne LLMs können nicht mehr halluzinieren. | |
| 4 | LLMs können viel längere Kontexte einbeziehen als n-Gramm-Modelle. | |
| 5 | Ein einfaches n-Gramm-Modell setzt nur Text im Stil seines Trainingskorpus fort. | |
| 6 | Mit dem n-Gramm-Modell sind die Ursachen von Halluzinationen bei LLMs vollständig erklärt. |
Verbesserungen:
Lösung vergleichen
| Nr. | r oder f? | Verbesserung |
|---|---|---|
| 1 | r | – |
| 2 | f | Das Modell hat keine Absicht und kein Verständnis. Es reiht Wörter nach statistischer Wahrscheinlichkeit aneinander, egal ob der Satz stimmt. |
| 3 | f | LLMs antworten häufig zuverlässiger, können aber weiterhin halluzinieren. |
| 4 | r | – |
| 5 | r | – |
| 6 | f | Das n-Gramm-Modell ist nur eine vereinfachte Analogie. Die Ursachen bei LLMs sind wesentlich komplexer. |
Ordne jede Beobachtung einem der vier Kriterien zu: Sprachqualität, Kontextberücksichtigung, Korrektheit oder Vielseitigkeit.
| Nr. | Beobachtung | Kriterium |
|---|---|---|
| 1 | Ein LLM übersetzt einen Text ins Englische und fasst ihn danach zusammen. | |
| 2 | Das Bigramm-Modell achtet bei der Wahl des nächsten Wortes nur auf das letzte Wort. | |
| 3 | Ein LLM schreibt flüssige, grammatisch richtige Sätze. | |
| 4 | Ein LLM nennt eine falsche Jahreszahl, obwohl die Antwort sehr sicher klingt. | |
| 5 | Das n-Gramm-Modell erzeugt „den hund läuft zur katze“. | |
| 6 | Ein LLM bezieht sich in seiner Antwort auf eine Frage, die viel weiter oben im Gespräch stand. |
Lösung vergleichen
| Nr. | Kriterium |
|---|---|
| 1 | Vielseitigkeit |
| 2 | Kontextberücksichtigung |
| 3 | Sprachqualität |
| 4 | Korrektheit |
| 5 | Sprachqualität |
| 6 | Kontextberücksichtigung |
Bei Nr. 5 kann man auch an Kontextberücksichtigung denken, denn der grammatische Fehler entsteht, weil das Modell „den“ nicht mehr beachtet. Beobachtet wird aber ein holpriger Satz, also geht es um die Sprachqualität.
Verwende das Bigramm-Modell zu den Steckbriefen.
- Bestimme die Folgewörter von „in“ und von „spielt“ mit ihren Wahrscheinlichkeiten.
- Das Modell erzeugt mit random einen Text aus 7 Wörtern, der mit „tom“ beginnt. Nenne alle Texte, die dabei entstehen können.
- Wie viele dieser Texte passen zum Korpus, wie viele sind Halluzinationen?
- Erkläre mit der Funktionsweise des Bigramm-Modells, warum die Halluzinationen entstehen.
Meine Antworten:
Lösung vergleichen
- Nach „in“ folgen „ottweiler“ und „neunkirchen“ je einmal, also je . Nach „spielt“ folgen „handball“ und „schach“ je einmal, also ebenfalls je 50 %.
- Bis „in“ ist alles festgelegt („tom wohnt in“), und nach „ottweiler“
bzw. „neunkirchen“ folgt immer „und spielt“. Gewählt wird nur nach „in“
und nach „spielt“. Deshalb gibt es vier mögliche Texte:
- tom wohnt in ottweiler und spielt handball
- tom wohnt in ottweiler und spielt schach
- tom wohnt in neunkirchen und spielt handball
- tom wohnt in neunkirchen und spielt schach
- Nur der letzte passt zum Korpus. Die anderen drei sind Halluzinationen.
- Das Bigramm-Modell schaut bei jedem Schritt nur auf das letzte Wort. Wenn es nach „in“ den Wohnort wählt, spielt „tom“ keine Rolle mehr – der Name liegt außerhalb des Kontexts. Ebenso wählt es nach „spielt“ das Hobby, ohne zu wissen, um wen es geht. Jedes Wortpaar stammt aus dem Korpus, deshalb klingt der Satz plausibel. Das Modell versteht aber nicht, dass Wohnort und Hobby zu einer bestimmten Person gehören.
Im Kundenservice eines Online-Shops fallen diese Tätigkeiten an:
- häufige Standardfragen im Chat beantworten (z. B. „Wo ist mein Paket?“),
- Antworten auf E-Mails vorformulieren,
- eine sehr verärgerte Kundin am Telefon beruhigen und eine faire Lösung mit ihr finden,
- eingehende Anfragen nach Themen sortieren,
- entscheiden, ob ein Kunde in einem Sonderfall sein Geld zurückbekommt.
- Ordne jede Tätigkeit zu: „wird schon heute durch generative KI unterstützt“ oder „aus heutiger Sicht schwer zu ersetzen“. Begründe die zweite Gruppe.
- Nenne eine neue Aufgabe, die in diesem Berufsfeld durch generative KI entsteht.
Meine Zuordnung und Begründung:
Lösung vergleichen
- Durch KI unterstützt: a), b) und d). Das sind häufige, ähnliche Aufgaben mit Texten, für die es viele Beispiele gibt. Schwer zu ersetzen: c) und e). Bei c) braucht man Einfühlungsvermögen und muss auf einen Menschen eingehen. Bei e) muss jemand eine Entscheidung treffen und dafür die Verantwortung übernehmen. Außerdem könnte ein Sprachmodell dabei halluzinieren, zum Beispiel eine Regel erfinden, die es gar nicht gibt.
- Zum Beispiel: die Antworten eines KI-Chatbots prüfen und verbessern, dem Chatbot gute Anweisungen geben (Prompt Engineering) oder festlegen, wann der Chatbot an einen Menschen weitergeben muss.
Worauf es ankommt: eine begründete Einschätzung. Auch eine andere Zuordnung ist möglich, wenn du sie gut begründest – zum Beispiel, dass b) zwar unterstützt wird, ein Mensch die Antwort aber vor dem Absenden prüfen sollte.
Verwende wieder den Korpus mit den Steckbriefen.
- Ein Trigramm-Modell (Kontext aus zwei Wörtern) erzeugt einen Text, der mit „tom wohnt“ beginnt. Kann dabei noch „tom wohnt in ottweiler“ entstehen? Begründe.
- Bestimme, wie viele Wörter der Kontext mindestens umfassen muss, damit das Modell ab „tom wohnt in“ nur noch den richtigen Steckbrief erzeugen kann. Begründe für den Wohnort und für das Hobby.
- Beschreibe, welchen Nachteil ein so langer Kontext hat.
Meine Antworten:
Lösung vergleichen
- Ja. Der Kontext für den Wohnort ist „wohnt in“. Danach folgen im Korpus „ottweiler“ und „neunkirchen“ je einmal. Der Name „tom“ liegt wieder außerhalb des Kontexts. Genauso ist es beim Hobby: Nach „und spielt“ folgen „handball“ und „schach“.
- Der Kontext muss drei Wörter umfassen
(4-Gramm-Modell):
- Wohnort: Erst der Kontext „tom wohnt in“ enthält den Namen. Danach folgt nur „neunkirchen“.
- Hobby: Der Kontext „neunkirchen und spielt“ enthält den Wohnort, und der gehört eindeutig zu Tom. Danach folgt nur „schach“.
- Mit drei Wörtern Kontext gibt es in diesem Korpus nirgends mehr eine Auswahl. Das Modell schreibt den Korpus nur noch wörtlich ab und kann keinen neuen Satz bilden: Der Text ist kohärent, aber nicht mehr variantenreich. Außerdem findet es zu einem Startkontext, der so nicht im Korpus steht (z. B. „tom lebt in“), gar keine Fortsetzung.
4.5.7Das Wichtigste in Kürze
- Eine Halluzination ist ein Text, der sprachlich plausibel klingt, aber inhaltlich falsch oder unsinnig ist.
- Beim n-Gramm-Modell entsteht sie, weil nur die letzten ein bis zwei Wörter als Kontext zählen und die Bedeutung keine Rolle spielt: Jedes Wortpaar stammt aus dem Korpus, die Kombination kann trotzdem falsch sein. Längere n-Gramme helfen nur, bis das Modell bloß noch abschreibt.
- LLMs sind besser in Sprachqualität, Kontextberücksichtigung und Vielseitigkeit und meist zuverlässiger – sie halluzinieren aber aus demselben Grund.
- Aussagen von KI-Systemen muss man selbst mit seriösen Quellen prüfen. Das schützt vor Desinformation und Manipulation.
- Generative KI verändert Berufe: Tätigkeiten werden unterstützt oder fallen weg, neue Aufgaben entstehen.
4.6Kapitel 4 kompakt: der Lernzettel
Diesen Abschnitt als PDF (S. 73–75)
Hier steht das Wichtigste aus Kapitel 4 auf wenigen Seiten, zum Wiederholen vor einem GLN. Wenn dir etwas unklar ist, lies im passenden Abschnitt nach: Dort ist alles ausführlich erklärt, mit Beispielen und Aufgaben.
4.6.1Sprachmodelle: Regeln oder Statistik? (Abschnitt 4.1)
- Ein Sprachmodell ist ein System, das sprachliche Strukturen bzw. Wahrscheinlichkeiten erfasst, um Texte zu analysieren oder neu zu erzeugen.
- Regelbasierte Systeme (z. B. ELIZA, 1966) reagieren nach fest programmierten Regeln und Mustererkennung: „Wenn der Satz ‚ich fühle mich …‘ enthält, antworte ‚Warum fühlst du dich …?’“. Die Regeln werden von oben nach unten geprüft, die erste passende gewinnt.
- n-Gramm-Modelle zählen in großen Textmengen, wie häufig Wortfolgen vorkommen, und sagen damit das nächste Wort voraus.
- Moderne LLMs (Large Language Models) nutzen komplexe neuronale Netze, schätzen im Kern aber ebenfalls Wahrscheinlichkeiten für die Fortsetzung eines Textes.
| regelbasiertes System | n-Gramm-Modell | |
|---|---|---|
| Woher kommt das Wissen? | Menschen schreiben Regeln. | Der Computer zählt in Texten. |
| Grenze | Für jede Formulierung bräuchte man eine Regel. | Kann nur, was im Korpus vorkam. |
| Versteht es die Bedeutung? | nein | nein |
Typische Fehler: Meinen, ELIZA „verstehe“ den Satz. Vergessen, dass die Reihenfolge der Regeln entscheidet, wenn mehrere passen.
4.6.2n-Gramme zählen, Wahrscheinlichkeiten berechnen (Abschnitte 4.2 und 4.3)
- Ein n-Gramm ist eine Folge von aufeinanderfolgenden Wörtern (oder Zeichen). Die Stücke überlappen sich.
| Name | n | aus „der hund bellt laut“ |
|---|---|---|
| Unigramm | 1 | der · hund · bellt · laut |
| Bigramm | 2 | der hund · hund bellt · bellt laut |
| Trigramm | 3 | der hund bellt · hund bellt laut |
- Der Textkorpus ist der Trainingstext. Bei der Textkörperanalyse zählt man, wie oft jedes n-Gramm darin vorkommt.
- Ein Text mit 9 Wörtern hat 8 Bigramme: Das letzte Wort hat keinen Nachfolger.
- Der Kontext ist das, worauf das Modell schaut: beim Bigramm ein Wort, beim Trigramm zwei Wörter.
- Wahrscheinlichkeit eines Folgewortes:
- Kontrolle: Für jeden Kontext ergeben die Wahrscheinlichkeiten zusammen 1 (100 %).
Beispiel zum Korpus „ich mag tee ich mag kaffee ich trinke tee“ (9 Wörter, 8 Bigramme):
| Kontext | Folgewort | Anzahl | Wahrscheinlichkeit |
|---|---|---|---|
| ich | mag | 2 | |
| ich | trinke | 1 | |
| mag | tee | 1 | |
| mag | kaffee | 1 | |
| tee | ich | 1 | |
| kaffee | ich | 1 | |
| trinke | tee | 1 |
- Große Korpora zählt man automatisiert mit Software (z. B. SoekiaGPT oder ein eigenes Python-Programm).
- Die Ergebnisse werden tabellarisch verwaltet: zu
jedem Kontext die Folgewörter mit Anzahl. Gängige Datenstruktur: ein
Dictionary von Dictionaries
{kontext: {folgewort: anzahl}}, für das Beispiel oben:
{"ich": {"mag": 2, "trinke": 1}, "mag": {"tee": 1, "kaffee": 1}, ...}Alle Bigramme eines Textes ausgeben:
woerter = korpus.split()               # Text -> Liste von Wörtern
for i in range(len(woerter) - 1):      # bis zum vorletzten Wort!
    print(woerter[i], woerter[i + 1])
Typische Fehler: Durch die Anzahl
aller Bigramme teilen statt durch die Bigramme, die mit
dem Kontext beginnen. Das letzte Wort mitzählen, obwohl
ihm kein Wort folgt. range(len(woerter)) statt
range(len(woerter) - 1) führt zum IndexError.
„Der“ und „der“ sind für den Computer verschiedene Wörter, deshalb alles
kleinschreiben.
4.6.3Texte erzeugen: next word prediction und Sampling (Abschnitt 4.4)
- Textgenerierung (next word prediction): Ab einem Startwort wird mithilfe der n-Gramm-Tabelle immer wieder das nächste Wort bestimmt und angehängt. Hat das letzte Wort keine Folgewörter, endet der Text.
- Die Sampling-Strategie legt fest, wie aus mehreren Folgewörtern eines ausgewählt wird:
| Strategie | Auswahl | Folge |
|---|---|---|
| greedy | immer das wahrscheinlichste Folgewort | deterministisch, oft eintönig und sich wiederholend |
| random | zufällig, gewichtet nach Wahrscheinlichkeit | abwechslungsreicher, manchmal unsinnig |
| top-k | nur die wahrscheinlichsten, darunter gewichtet zufällig | Kompromiss zwischen Vorhersagbarkeit und Abwechslung |
- Top-k neu rechnen: Folgewörter 4-mal, 3-mal, 2-mal, 1-mal. Bei random . Bei top-2 bleiben zwei Wörter mit Vorkommen: und .
- Länge des n-Gramms: Größere (z. B. Trigramme statt Bigramme) ergeben kohärentere, aber weniger variantenreiche Texte. Der längere Kontext ist spezifischer und kommt seltener im Korpus vor. Bei kleinem Korpus bricht die Generierung schneller ab.
- Trainingsdaten: Das Modell kann nur Wörter und Wortfolgen aus seinem Korpus erzeugen. Ein anderer Korpus ergibt ganz andere Texte. Ein Sprachmodell erzeugt deshalb nicht automatisch neutralen Text.
Typische Fehler: Bei top-k weiter durch die alte Gesamtzahl teilen. Glauben, random wähle alle Wörter gleich oft: Häufige Wörter werden öfter gezogen. Vergessen, dass greedy immer denselben Text liefert.
4.6.4Halluzination und moderne LLMs (Abschnitt 4.5)
- Eine Halluzination ist ein Text, der grammatikalisch bzw. statistisch plausibel, aber inhaltlich falsch oder unsinnig ist.
- Ursache beim n-Gramm-Modell: Es hat kein Verständnis der Bedeutung. Es reiht Wörter nach statistischer Wahrscheinlichkeit aneinander und schaut nur auf den kurzen Kontext. Jedes Wortpaar stammt aus dem Korpus, die Kombination kann trotzdem falsch sein.
| Kriterium | n-Gramm-Modell | modernes LLM |
|---|---|---|
| Sprachqualität | oft holprig | flüssig, grammatisch meist korrekt |
| Kontextberücksichtigung | nur 1–2 vorherige Wörter | sehr lange Kontexte |
| Korrektheit | Inhalt oft zufällig falsch | häufig zuverlässiger, kann aber weiterhin halluzinieren |
| Vielseitigkeit | setzt nur Text im Stil seines Korpus fort | übersetzen, zusammenfassen, programmieren … |
- Das n-Gramm-Modell ist für Halluzinationen bei LLMs nur eine vereinfachte Analogie. Die Ursachen bei LLMs sind wesentlich komplexer.
- Generative KI und Berufe: Manche Tätigkeiten werden unterstützt oder verändert, es entstehen neue Aufgaben (z. B. Prompt Engineering), manche Tätigkeiten sind schwer zu ersetzen. Zu einer Bewertung gehören Chancen und Risiken.
Typische Fehler: „Das Modell lügt“ – es hat keine Absicht, es rechnet nur. „LLMs halluzinieren nicht mehr“ – doch, auch sie können es. Eine Halluzination nur „falsch“ nennen, ohne die Ursache (Wahrscheinlichkeit statt Bedeutung, kurzer Kontext) zu erklären.
4.7Rückblick auf Kapitel 4
Diesen Abschnitt als PDF (S. 76–77)
Am Ende des Kapitels lohnt sich ein Blick zurück: Welche Fachbegriffe kennst du jetzt? Was kannst du schon sicher, was solltest du noch einmal üben?
4.7.1Die Basisbegriffe
Die ersten sechs Begriffe nennt der Lehrplan als Basisbegriffe. Du solltest jeden davon mit eigenen Worten erklären und an einem kleinen Beispiel zeigen können.
| Begriff | Bedeutung |
|---|---|
| Sprachmodell | System, das Wahrscheinlichkeiten für Wortfolgen erfasst, um Texte zu analysieren oder zu erzeugen |
| regelbasiertes System | arbeitet mit festen, von Menschen geschriebenen Regeln (z. B. ELIZA) |
| n-Gramm-Modell | statistisches Sprachmodell, das das nächste Wort aus den vorherigen Wörtern vorhersagt |
| Textkörperanalyse | Auszählen, wie oft Wortfolgen (n-Gramme) in einem Textkörper (Korpus) vorkommen |
| Textgenerierung | Erzeugen von Text, Wort für Wort (next word prediction) |
| Sampling | Auswahl des nächsten Wortes aus den möglichen Folgewörtern; die Sampling-Strategie (greedy, random, top-k) legt fest, wie ausgewählt wird |
| Halluzination | flüssig klingender, aber inhaltlich falscher oder erfundener Text |
4.7.2Kompetenz-Check
Kreuze ehrlich an, wie sicher du dich fühlst. Wo du „noch nicht“ ankreuzt, lies den passenden Abschnitt noch einmal und bearbeite seine Arbeitsaufträge.
| Ich kann … | sicher | teilweise | noch nicht |
|---|---|---|---|
| den Begriff Sprachmodell erläutern. | |||
| regelbasierte Systeme (z. B. ELIZA) und n-Gramm-Modelle unterscheiden. | |||
| in einem Text n-Gramm-Häufigkeiten auszählen und Wahrscheinlichkeiten berechnen. | |||
| Sampling-Strategien (greedy, random, top-k) benennen und anwenden. | |||
| erläutern, wie der erzeugte Text von den Trainingsdaten abhängt. | |||
| beschreiben, wie sich die n-Gramm-Länge auf den erzeugten Text auswirkt. | |||
| Halluzinationen anhand von n-Gramm-Modellen erklären. | |||
| Unterschiede zwischen n-Gramm-Modellen und modernen LLMs beschreiben. | |||
| Auswirkungen generativer KI auf Berufe recherchieren. |